{"metadata":{"kernelspec":{"language":"python","display_name":"Python 3","name":"python3"},"language_info":{"pygments_lexer":"ipython3","nbconvert_exporter":"python","version":"3.6.4","file_extension":".py","codemirror_mode":{"name":"ipython","version":3},"name":"python","mimetype":"text/x-python"}},"nbformat_minor":4,"nbformat":4,"cells":[{"cell_type":"code","source":"# This Python 3 environment comes with many helpful analytics libraries installed\n# It is defined by the kaggle/python Docker image: https://github.com/kaggle/docker-python\n# For example, here's several helpful packages to load\n\nimport numpy as np # linear algebra\nimport pandas as pd # data processing, CSV file I/O (e.g. pd.read_csv)\n\n# Input data files are available in the read-only \"../input/\" directory\n# For example, running this (by clicking run or pressing Shift+Enter) will list all files under the input directory\n\nimport os\nfor dirname, _, filenames in os.walk('/kaggle/input'):\n for filename in filenames:\n print(os.path.join(dirname, filename))\n\n# You can write up to 20GB to the current directory (/kaggle/working/) that gets preserved as output when you create a version using \"Save & Run All\" \n# You can also write temporary files to /kaggle/temp/, but they won't be saved outside of the current session","metadata":{"_cell_guid":"b1076dfc-b9ad-4769-8c92-a6c4dae69d19","_uuid":"8f2839f25d086af736a60e9eeb907d3b93b6e0e5","papermill":{"duration":6.659366,"end_time":"2022-10-04T16:24:11.056544","exception":false,"start_time":"2022-10-04T16:24:04.397178","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:17:57.860348Z","iopub.execute_input":"2022-10-18T17:17:57.861577Z","iopub.status.idle":"2022-10-18T17:17:57.870472Z","shell.execute_reply.started":"2022-10-18T17:17:57.861521Z","shell.execute_reply":"2022-10-18T17:17:57.868968Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"# Importing the library ","metadata":{"papermill":{"duration":0.025005,"end_time":"2022-10-04T16:24:11.112171","exception":false,"start_time":"2022-10-04T16:24:11.087166","status":"completed"},"tags":[]}},{"cell_type":"code","source":"import numpy as np \nimport pandas as pd\nimport os\nimport torch\nfrom torch import nn\nfrom torch import optim\nfrom torch.utils.tensorboard import SummaryWriter\nfrom torch.utils.data import Dataset, DataLoader\nfrom torchvision import transforms\n# import torchvision.transforms.functional as TF\n\nimport random\nimport os, shutil\nimport numpy as np\nimport pandas as pd\nfrom PIL import Image\nfrom tqdm.auto import tqdm\nimport matplotlib.pyplot as plt\nimport matplotlib.image as mpimg\nimport os\nfrom os.path import join\nimport matplotlib.pyplot as plt\nplt.rcParams.update({'font.size': 18})\nimport cv2\n\nimport torch.nn.functional as F\nfrom torch.utils.data import DataLoader, Dataset, sampler\nfrom albumentations import (HorizontalFlip, VerticalFlip, ShiftScaleRotate, Normalize, Resize, Compose, GaussNoise)\n\nfrom sklearn.model_selection import train_test_split\nfrom sklearn.metrics import accuracy_score, f1_score,roc_auc_score,recall_score,precision_score\nimport warnings\nwarnings.filterwarnings('ignore')","metadata":{"papermill":{"duration":3.903221,"end_time":"2022-10-04T16:24:15.040285","exception":false,"start_time":"2022-10-04T16:24:11.137064","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:17:57.872817Z","iopub.execute_input":"2022-10-18T17:17:57.873515Z","iopub.status.idle":"2022-10-18T17:17:57.887034Z","shell.execute_reply.started":"2022-10-18T17:17:57.873461Z","shell.execute_reply":"2022-10-18T17:17:57.885624Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"# Data Loading and Preprocessing","metadata":{"papermill":{"duration":0.022755,"end_time":"2022-10-04T16:24:15.086583","exception":false,"start_time":"2022-10-04T16:24:15.063828","status":"completed"},"tags":[]}},{"cell_type":"code","source":"data_train = pd.read_csv('../input/sartorius-cell-instance-segmentation/train.csv')","metadata":{"papermill":{"duration":0.609566,"end_time":"2022-10-04T16:24:15.718814","exception":false,"start_time":"2022-10-04T16:24:15.109248","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:21:18.909955Z","iopub.execute_input":"2022-10-18T17:21:18.910427Z","iopub.status.idle":"2022-10-18T17:21:19.871870Z","shell.execute_reply.started":"2022-10-18T17:21:18.910392Z","shell.execute_reply":"2022-10-18T17:21:19.870653Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"data_train.head()","metadata":{"papermill":{"duration":0.047421,"end_time":"2022-10-04T16:24:15.799458","exception":false,"start_time":"2022-10-04T16:24:15.752037","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:21:22.857688Z","iopub.execute_input":"2022-10-18T17:21:22.858273Z","iopub.status.idle":"2022-10-18T17:21:22.888829Z","shell.execute_reply.started":"2022-10-18T17:21:22.858227Z","shell.execute_reply":"2022-10-18T17:21:22.887351Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"DATA_PATH = '../input/sartorius-cell-instance-segmentation'\nTRAIN_CSV = join(DATA_PATH,'train.csv')\nTRAIN_PATH = join(DATA_PATH,'train')\ndf_train = pd.read_csv(TRAIN_CSV)\nprint(f'Training Set Shape: {df_train.shape} - {df_train[\"id\"].nunique()} \\\nImages - Memory Usage: {df_train.memory_usage().sum() / 1024 ** 2:.2f} MB')","metadata":{"papermill":{"duration":0.294628,"end_time":"2022-10-04T16:24:16.117373","exception":false,"start_time":"2022-10-04T16:24:15.822745","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:21:25.265306Z","iopub.execute_input":"2022-10-18T17:21:25.265878Z","iopub.status.idle":"2022-10-18T17:21:25.692126Z","shell.execute_reply.started":"2022-10-18T17:21:25.265822Z","shell.execute_reply":"2022-10-18T17:21:25.690814Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"## Decoding data and build masks for all images\n\nMasks are encoded in the annotation column by an algorithm called Run Length Encoding. RLE encodes a mask into a vector where vector index corresponds to flattened mask matrix index and the value at that index corresponds to length of the annotation, for a more in depth understanding I recommend looking into this notebook","metadata":{"papermill":{"duration":0.027255,"end_time":"2022-10-04T16:24:16.170059","exception":false,"start_time":"2022-10-04T16:24:16.142804","status":"completed"},"tags":[]}},{"cell_type":"code","source":"def rle_decode(mask_rle, shape, color=1):\n '''\n mask_rle: run-length as string formated (start length)\n shape: (height,width) of array to return \n Returns numpy array, 1 - mask, 0 - background\n\n '''\n s = mask_rle.split()\n starts, lengths = [np.asarray(x, dtype=int) for x in (s[0:][::2], s[1:][::2])]\n starts -= 1\n ends = starts + lengths\n img = np.zeros(shape[0] * shape[1], dtype=np.float32)\n for lo, hi in zip(starts, ends):\n img[lo : hi] = color\n return img.reshape(shape)\ndef build_masks(df_train, image_id, input_shape):\n height, width = input_shape\n labels = df_train[df_train[\"id\"] == image_id][\"annotation\"].tolist()\n mask = np.zeros((height, width))\n for label in labels:\n mask += rle_decode(label, shape=(height, width))\n mask = mask.clip(0, 1)\n return np.array(mask)","metadata":{"papermill":{"duration":0.035075,"end_time":"2022-10-04T16:24:16.228047","exception":false,"start_time":"2022-10-04T16:24:16.192972","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:21:27.880702Z","iopub.execute_input":"2022-10-18T17:21:27.881356Z","iopub.status.idle":"2022-10-18T17:21:27.893649Z","shell.execute_reply.started":"2022-10-18T17:21:27.881308Z","shell.execute_reply":"2022-10-18T17:21:27.892182Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"cell_types = df_train[\"cell_type\"].value_counts()\n\nplt.figure(figsize=(10, 6), tight_layout=True)\n\nplt.bar(cell_types.index, cell_types.values)\nplt.show()","metadata":{"papermill":{"duration":0.242132,"end_time":"2022-10-04T16:24:16.493305","exception":false,"start_time":"2022-10-04T16:24:16.251173","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:21:29.729021Z","iopub.execute_input":"2022-10-18T17:21:29.729524Z","iopub.status.idle":"2022-10-18T17:21:29.947673Z","shell.execute_reply.started":"2022-10-18T17:21:29.729474Z","shell.execute_reply":"2022-10-18T17:21:29.946076Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"## Data processing and augmentation","metadata":{"papermill":{"duration":0.023236,"end_time":"2022-10-04T16:24:16.540862","exception":false,"start_time":"2022-10-04T16:24:16.517626","status":"completed"},"tags":[]}},{"cell_type":"code","source":"class CellDataset(Dataset):\n def __init__(self, df: pd.core.frame.DataFrame, train:bool):\n self.IMAGE_RESIZE = (224, 224)\n self.RESNET_MEAN = (0.485, 0.456, 0.406)\n self.RESNET_STD = (0.229, 0.224, 0.225)\n self.df = df\n self.base_path = TRAIN_PATH\n self.gb = self.df.groupby('id')\n self.transforms = Compose([Resize(self.IMAGE_RESIZE[0], self.IMAGE_RESIZE[1]),\n Normalize(mean=self.RESNET_MEAN, std= self.RESNET_STD, p=1),\n HorizontalFlip(p=0.5),\n VerticalFlip(p=0.5)])\n \n # Split train and val set\n all_image_ids = np.array(df_train.id.unique())\n np.random.seed(42)\n# iperm = np.random.permutation(len(all_image_ids))\n num_train_samples = int(len(all_image_ids) * 0.9)\n\n if train:\n self.image_ids = all_image_ids[:num_train_samples]\n else:\n self.image_ids = all_image_ids[num_train_samples:]\n\n def __getitem__(self, idx: int) -> dict:\n\n image_id = self.image_ids[idx]\n df = self.gb.get_group(image_id)\n\n # Read image\n image_path = os.path.join(self.base_path, image_id + \".png\")\n image = cv2.imread(image_path)\n\n # Create the mask\n mask = build_masks(df_train, image_id, input_shape=(520, 704))\n mask = (mask >= 1).astype('float32')\n augmented = self.transforms(image=image, mask=mask)\n image = augmented['image']\n mask = augmented['mask']\n # print(np.moveaxis(image,0,2).shape)\n return np.moveaxis(np.array(image),2,0), mask.reshape((1, self.IMAGE_RESIZE[0], self.IMAGE_RESIZE[1]))\n\n\n def __len__(self):\n return len(self.image_ids)","metadata":{"papermill":{"duration":0.037973,"end_time":"2022-10-04T16:24:16.602466","exception":false,"start_time":"2022-10-04T16:24:16.564493","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:21:31.760996Z","iopub.execute_input":"2022-10-18T17:21:31.761546Z","iopub.status.idle":"2022-10-18T17:21:31.778123Z","shell.execute_reply.started":"2022-10-18T17:21:31.761507Z","shell.execute_reply":"2022-10-18T17:21:31.776398Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"ds_train = CellDataset(df_train, train=True)\ndl_train = DataLoader(ds_train, batch_size=16, num_workers=2, pin_memory=True, shuffle=False)","metadata":{"papermill":{"duration":0.037157,"end_time":"2022-10-04T16:24:16.663468","exception":false,"start_time":"2022-10-04T16:24:16.626311","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:21:32.596632Z","iopub.execute_input":"2022-10-18T17:21:32.597188Z","iopub.status.idle":"2022-10-18T17:21:32.610187Z","shell.execute_reply.started":"2022-10-18T17:21:32.597146Z","shell.execute_reply":"2022-10-18T17:21:32.608841Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"ds_test = CellDataset(df_train, train=False)\ndl_test = DataLoader(ds_test, batch_size=4, num_workers=2, pin_memory=True, shuffle=False)","metadata":{"papermill":{"duration":0.036302,"end_time":"2022-10-04T16:24:16.723540","exception":false,"start_time":"2022-10-04T16:24:16.687238","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:21:37.634274Z","iopub.execute_input":"2022-10-18T17:21:37.635376Z","iopub.status.idle":"2022-10-18T17:21:37.648089Z","shell.execute_reply.started":"2022-10-18T17:21:37.635317Z","shell.execute_reply":"2022-10-18T17:21:37.646918Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"# Data explore and Visualization","metadata":{"papermill":{"duration":0.022835,"end_time":"2022-10-04T16:24:16.769616","exception":false,"start_time":"2022-10-04T16:24:16.746781","status":"completed"},"tags":[]}},{"cell_type":"code","source":"df_train=data_train\ndf_train.head()","metadata":{"papermill":{"duration":0.03879,"end_time":"2022-10-04T16:24:16.832322","exception":false,"start_time":"2022-10-04T16:24:16.793532","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:21:40.086547Z","iopub.execute_input":"2022-10-18T17:21:40.087116Z","iopub.status.idle":"2022-10-18T17:21:40.105759Z","shell.execute_reply.started":"2022-10-18T17:21:40.087070Z","shell.execute_reply":"2022-10-18T17:21:40.104076Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"df_train.info()","metadata":{"papermill":{"duration":0.062533,"end_time":"2022-10-04T16:24:16.917582","exception":false,"start_time":"2022-10-04T16:24:16.855049","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:21:41.193144Z","iopub.execute_input":"2022-10-18T17:21:41.193706Z","iopub.status.idle":"2022-10-18T17:21:41.251976Z","shell.execute_reply.started":"2022-10-18T17:21:41.193663Z","shell.execute_reply":"2022-10-18T17:21:41.250845Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"print(f'Number of images: {df_train.id.nunique()}')","metadata":{"papermill":{"duration":0.036683,"end_time":"2022-10-04T16:24:16.977786","exception":false,"start_time":"2022-10-04T16:24:16.941103","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:22:14.491136Z","iopub.execute_input":"2022-10-18T17:22:14.491706Z","iopub.status.idle":"2022-10-18T17:22:14.506053Z","shell.execute_reply.started":"2022-10-18T17:22:14.491659Z","shell.execute_reply":"2022-10-18T17:22:14.504482Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"fig, ax = plt.subplots()\n\nninstances_per_image = df_train[['id']].value_counts().sort_values()\nninstances_per_image.index = range(606)\nninstances_per_image.median()\nninstances_per_image.plot.bar(ax=ax)\n\nax.set_xticklabels([])\nax.set_xlabel('Images')\nax.set_ylabel('Number of Instances')\nplt.show()","metadata":{"papermill":{"duration":2.633266,"end_time":"2022-10-04T16:24:19.634505","exception":false,"start_time":"2022-10-04T16:24:17.001239","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:22:16.964238Z","iopub.execute_input":"2022-10-18T17:22:16.964759Z","iopub.status.idle":"2022-10-18T17:22:19.799632Z","shell.execute_reply.started":"2022-10-18T17:22:16.964708Z","shell.execute_reply":"2022-10-18T17:22:19.798402Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"fig, ax = plt.subplots(1, 1)\ndf_train.groupby(['id','cell_type'])['cell_type'].first().value_counts().plot.bar(ax=ax)\nax.set_ylabel('Number of Images')\nax.set_xlabel('Cell Types')\nfig.tight_layout()\nplt.show()","metadata":{"papermill":{"duration":0.237971,"end_time":"2022-10-04T16:24:19.897114","exception":false,"start_time":"2022-10-04T16:24:19.659143","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:22:25.082422Z","iopub.execute_input":"2022-10-18T17:22:25.082935Z","iopub.status.idle":"2022-10-18T17:22:25.346678Z","shell.execute_reply.started":"2022-10-18T17:22:25.082889Z","shell.execute_reply":"2022-10-18T17:22:25.345307Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"## Image\nHere we first show 3 image of each cell types, then randomly show 9 image, then show the relationship of image and mask.","metadata":{"papermill":{"duration":0.024112,"end_time":"2022-10-04T16:24:19.951152","exception":false,"start_time":"2022-10-04T16:24:19.927040","status":"completed"},"tags":[]}},{"cell_type":"code","source":"def decode_rle_mask(rle_mask, shape):\n\n rle_mask = rle_mask.split()\n starts, lengths = [np.asarray(x, dtype=int) for x in (rle_mask[0:][::2], rle_mask[1:][::2])]\n starts -= 1\n ends = starts + lengths\n\n mask = np.zeros((shape[0] * shape[1]), dtype=np.uint8)\n for start, end in zip(starts, ends):\n mask[start:end] = 1\n\n mask = mask.reshape(shape[0], shape[1])\n return mask\n\ndef visualize_image(df, image_id): \n image_path = df.loc[df['id'] == image_id, 'id'].values[0]\n cell_type = df.loc[df['id'] == image_id, 'cell_type'].values[0]\n plate_time = df.loc[df['id'] == image_id, 'plate_time'].values[0]\n sample_date = df.loc[df['id'] == image_id, 'sample_date'].values[0]\n sample_id = df.loc[df['id'] == image_id, 'sample_id'].values[0]\n\n image = cv2.imread(f'../input/sartorius-cell-instance-segmentation/train/{image_path}.png')\n image = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)\n\n fig, axes = plt.subplots(figsize=(14, 14), ncols=2)\n fig.tight_layout(pad=5.0)\n \n axes[0].imshow(image, cmap='gray')\n masks = []\n for mask in df.loc[df['id'] == image_id, 'annotation'].values:\n decoded_mask = decode_rle_mask(rle_mask=mask, shape=image.shape)\n masks.append(decoded_mask)\n mask = np.stack(masks)\n mask = np.any(mask == 1, axis=0)\n axes[1].imshow(image, cmap='gray')\n axes[1].imshow(mask, alpha=0.4)\n\n for i in range(2):\n axes[i].set_xlabel('')\n axes[i].set_ylabel('')\n axes[i].tick_params(axis='x', labelsize=10, pad=10)\n axes[i].tick_params(axis='y', labelsize=10, pad=10)\n \n axes[0].set_title(f'{image_path} - {cell_type} Annotations\\n{plate_time} - {sample_date} - {sample_id}', fontsize=10, pad=12)\n axes[1].set_title('Segmentation Mask', fontsize=10, pad=12)\n plt.show()\n plt.close(fig)","metadata":{"papermill":{"duration":0.040713,"end_time":"2022-10-04T16:24:20.015879","exception":false,"start_time":"2022-10-04T16:24:19.975166","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:22:30.651175Z","iopub.execute_input":"2022-10-18T17:22:30.651742Z","iopub.status.idle":"2022-10-18T17:22:30.669880Z","shell.execute_reply.started":"2022-10-18T17:22:30.651695Z","shell.execute_reply":"2022-10-18T17:22:30.668214Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"## astro cells","metadata":{"papermill":{"duration":0.023925,"end_time":"2022-10-04T16:24:20.063108","exception":false,"start_time":"2022-10-04T16:24:20.039183","status":"completed"},"tags":[]}},{"cell_type":"code","source":"select_image_ids = []\nselect_image_ids.append(df_train.loc[df_train['cell_type'] == 'astro', 'id'].sample(1).to_list()[0])\nselect_image_ids.append(df_train.loc[df_train['cell_type'] == 'astro', 'id'].sample(2).to_list()[0])\nselect_image_ids.append(df_train.loc[df_train['cell_type'] == 'astro', 'id'].sample(3).to_list()[0])\n\nfor image_id in select_image_ids:\n visualize_image(df=df_train, image_id=image_id)","metadata":{"papermill":{"duration":1.866365,"end_time":"2022-10-04T16:24:21.953443","exception":false,"start_time":"2022-10-04T16:24:20.087078","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:22:37.779208Z","iopub.execute_input":"2022-10-18T17:22:37.779702Z","iopub.status.idle":"2022-10-18T17:22:40.052512Z","shell.execute_reply.started":"2022-10-18T17:22:37.779665Z","shell.execute_reply":"2022-10-18T17:22:40.051121Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"## cort cells","metadata":{"papermill":{"duration":0.039403,"end_time":"2022-10-04T16:24:22.025950","exception":false,"start_time":"2022-10-04T16:24:21.986547","status":"completed"},"tags":[]}},{"cell_type":"code","source":"select_image_ids = []\nselect_image_ids.append(df_train.loc[df_train['cell_type'] == 'cort', 'id'].sample(1).to_list()[0])\nselect_image_ids.append(df_train.loc[df_train['cell_type'] == 'cort', 'id'].sample(2).to_list()[0])\nselect_image_ids.append(df_train.loc[df_train['cell_type'] == 'cort', 'id'].sample(3).to_list()[0])\n\nfor image_id in select_image_ids:\n visualize_image(df=df_train, image_id=image_id)","metadata":{"papermill":{"duration":1.81446,"end_time":"2022-10-04T16:24:23.875970","exception":false,"start_time":"2022-10-04T16:24:22.061510","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:22:54.569142Z","iopub.execute_input":"2022-10-18T17:22:54.570147Z","iopub.status.idle":"2022-10-18T17:22:56.584642Z","shell.execute_reply.started":"2022-10-18T17:22:54.570095Z","shell.execute_reply":"2022-10-18T17:22:56.583226Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"## shsy5y cell","metadata":{"papermill":{"duration":0.041233,"end_time":"2022-10-04T16:24:23.960131","exception":false,"start_time":"2022-10-04T16:24:23.918898","status":"completed"},"tags":[]}},{"cell_type":"code","source":"select_image_ids = []\nselect_image_ids.append(df_train.loc[df_train['cell_type'] == 'shsy5y', 'id'].sample(1).to_list()[0])\nselect_image_ids.append(df_train.loc[df_train['cell_type'] == 'shsy5y', 'id'].sample(2).to_list()[0])\nselect_image_ids.append(df_train.loc[df_train['cell_type'] == 'shsy5y', 'id'].sample(3).to_list()[0])\n\nfor image_id in select_image_ids:\n visualize_image(df=df_train, image_id=image_id)","metadata":{"papermill":{"duration":2.413213,"end_time":"2022-10-04T16:24:26.414679","exception":false,"start_time":"2022-10-04T16:24:24.001466","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:23:00.511195Z","iopub.execute_input":"2022-10-18T17:23:00.511786Z","iopub.status.idle":"2022-10-18T17:23:03.559697Z","shell.execute_reply.started":"2022-10-18T17:23:00.511729Z","shell.execute_reply":"2022-10-18T17:23:03.558555Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"# Modeling","metadata":{"papermill":{"duration":0.052474,"end_time":"2022-10-04T16:24:26.520402","exception":false,"start_time":"2022-10-04T16:24:26.467928","status":"completed"},"tags":[]}},{"cell_type":"markdown","source":"## Implement of training loop and evaluate loop","metadata":{"papermill":{"duration":0.053576,"end_time":"2022-10-04T16:24:26.627226","exception":false,"start_time":"2022-10-04T16:24:26.573650","status":"completed"},"tags":[]}},{"cell_type":"code","source":"device = torch.device('cuda') if torch.cuda.is_available() else torch.device('cpu')\n# device=torch.device('cpu')","metadata":{"papermill":{"duration":0.118963,"end_time":"2022-10-04T16:24:26.797745","exception":false,"start_time":"2022-10-04T16:24:26.678782","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:24:37.752368Z","iopub.execute_input":"2022-10-18T17:24:37.752910Z","iopub.status.idle":"2022-10-18T17:24:37.760168Z","shell.execute_reply.started":"2022-10-18T17:24:37.752869Z","shell.execute_reply":"2022-10-18T17:24:37.758660Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"!pip install livelossplot==0.3.4","metadata":{"papermill":{"duration":0.060559,"end_time":"2022-10-04T16:24:26.910269","exception":false,"start_time":"2022-10-04T16:24:26.849710","status":"completed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:24:54.942409Z","iopub.execute_input":"2022-10-18T17:24:54.943912Z","iopub.status.idle":"2022-10-18T17:25:09.496898Z","shell.execute_reply.started":"2022-10-18T17:24:54.943829Z","shell.execute_reply":"2022-10-18T17:25:09.495407Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"# training loop\nfrom livelossplot import PlotLosses\n\nliveloss = PlotLosses()\ndef train_loop(model, optimizer, criterion, train_loader, device=device):\n running_loss = 0\n model.train()\n pbar = tqdm(train_loader, desc='Iterating over train data')\n \n for imgs, masks in pbar:\n # pass to device\n imgs = imgs.to(device)\n masks = masks.to(device)\n # forward\n out = model(imgs)\n loss = criterion(out, masks)\n running_loss += loss.item()*imgs.shape[0] # += loss * current batch size\n \n # optimize\n optimizer.zero_grad()\n loss.backward()\n optimizer.step()\n running_loss /= len(train_loader.sampler)\n return running_loss","metadata":{"papermill":{"duration":0.241879,"end_time":"2022-10-04T16:24:27.202802","exception":true,"start_time":"2022-10-04T16:24:26.960923","status":"failed"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:25:09.499871Z","iopub.execute_input":"2022-10-18T17:25:09.500416Z","iopub.status.idle":"2022-10-18T17:25:09.516351Z","shell.execute_reply.started":"2022-10-18T17:25:09.500358Z","shell.execute_reply":"2022-10-18T17:25:09.514757Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"# Evaluation loop\ndef eval_loop(model, criterion, eval_loader, device=device):\n running_loss = 0\n model.eval()\n with torch.no_grad():\n accuracy, f1_scores = [],[]\n pbar = tqdm(eval_loader, desc='Iterating over evaluation data')\n \n for imgs, masks in pbar:\n # pass to device\n li=imgs\n lm=masks\n imgs = imgs.to(device)\n masks = masks.to(device)\n # forward\n out = model(imgs)\n# print(out.shape)\n loss = criterion(out, masks)\n running_loss += loss.item()*imgs.shape[0]\n \n # calculate predictions using output\n predicted = (out > 0.5).float()\n predicted = predicted.view(-1).cpu().numpy()\n labels = masks.view(-1).cpu().numpy()\n accuracy.append(accuracy_score(labels, predicted))\n f1_scores.append(f1_score(labels, predicted))\n \n acc = sum(accuracy)/len(accuracy)\n f1 = sum(f1_scores)/len(f1_scores)\n running_loss /= len(eval_loader.sampler)\n return {\n 'accuracy':acc,\n 'f1_macro':f1, \n 'loss':running_loss,\n 'img': li,\n 'masks': lm,\n 'out':out\n }","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:25:09.518508Z","iopub.execute_input":"2022-10-18T17:25:09.518998Z","iopub.status.idle":"2022-10-18T17:25:09.532349Z","shell.execute_reply.started":"2022-10-18T17:25:09.518951Z","shell.execute_reply":"2022-10-18T17:25:09.530742Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"# train the model\ndef train(model, optimizer, criterion, train_loader, valid_loader,\n device=device, \n num_epochs=25, \n valid_loss_min=np.inf,\n logdir='logdir'):\n \n tb_writer = SummaryWriter(log_dir=logdir)\n val_loss_list = []\n for e in range(num_epochs):\n # train for epoch\n train_loss = train_loop(\n model, optimizer, criterion, train_loader, device=device)\n # evaluate on validation set\n metrics = eval_loop(\n model, criterion, valid_loader, device=device\n )\n # show progress\n print_string = f'Epoch: {e+1} '\n print_string+= f'TrainLoss: {train_loss:.5f} '\n print_string+= f'ValidLoss: {metrics[\"loss\"]:.5f} '\n print_string+= f'ACC: {metrics[\"accuracy\"]:.5f} '\n print_string+= f'F1: {metrics[\"f1_macro\"]:.3f}'\n liveloss.update({'Training loss': metrics[\"loss\"],'Accuracy': metrics[\"accuracy\"]})\n liveloss.draw()\n # Tensorboards Logging\n tb_writer.add_scalar('UNet/Train Loss', train_loss, e)\n tb_writer.add_scalar('UNet/Valid Loss', metrics[\"loss\"], e)\n tb_writer.add_scalar('UNet/Accuracy', metrics[\"accuracy\"], e)\n tb_writer.add_scalar('UNet/F1 Macro', metrics[\"f1_macro\"], e)\n\n # save the model \n if metrics[\"loss\"] <= valid_loss_min:\n torch.save(model.state_dict(), 'model.pt')\n valid_loss_min = metrics[\"loss\"]","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:25:10.398897Z","iopub.execute_input":"2022-10-18T17:25:10.399520Z","iopub.status.idle":"2022-10-18T17:25:10.413916Z","shell.execute_reply.started":"2022-10-18T17:25:10.399476Z","shell.execute_reply":"2022-10-18T17:25:10.411481Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"# CNN\nHere, we use CNN to achieve cell instance segmentation task. In this task, the input of CNN is the original image, and the output should be the mask image. In this part, four layers of fully convolutional network was used to extract feature and output mask.","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]}},{"cell_type":"markdown","source":"## Implement of CNN mode","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]}},{"cell_type":"code","source":"class CNN(nn.Module):\n def __init__(self, in_channels, num_classes):\n super(CNN, self).__init__()\n self.cov1=nn.Conv2d(in_channels, 20, kernel_size=5, padding=\"same\")\n self.btn=nn.BatchNorm2d(20)\n self.relu=nn.ReLU()\n self.cov2=nn.Conv2d(20, 10, kernel_size=1)\n self.cov3=nn.Conv2d(10, 10, kernel_size=5, padding=\"same\")\n self.btn2=nn.BatchNorm2d(10)\n self.cov4=nn.Conv2d(10, num_classes, kernel_size=1)\n self.sigmod=nn.Sigmoid()\n \n def forward(self, x):\n # print(x.shape)\n x1 = self.cov1(x)\n # print(x1.shape)\n x2 = self.btn(x1)\n # print(x2.shape)\n x3 = self.relu(x2)\n # print(x3.shape)\n x4 = self.cov2(x3)\n # print(x4.shape)\n x5 = self.cov3(x4)\n # print(x5.shape)\n # print('up')\n x = self.btn2(x4)\n # print(x.shape)\n x = self.relu(x)\n # print(x.shape)\n x = self.cov4(x)\n # print(x.shape)\n x = self.sigmod(x)\n # print(x.shape)\n return x","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:25:22.663410Z","iopub.execute_input":"2022-10-18T17:25:22.663926Z","iopub.status.idle":"2022-10-18T17:25:22.676478Z","shell.execute_reply.started":"2022-10-18T17:25:22.663884Z","shell.execute_reply":"2022-10-18T17:25:22.675430Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"## Train and evaluted the CNN model","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]}},{"cell_type":"code","source":"model1 = CNN(3, 1).to(device)\noptimizer = optim.Adam(model1.parameters(), lr=0.01)\ncriterion = nn.BCELoss()\ntrain(model1, optimizer, criterion, dl_train, dl_test)","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:25:30.909103Z","iopub.execute_input":"2022-10-18T17:25:30.909580Z","iopub.status.idle":"2022-10-18T17:53:10.560490Z","shell.execute_reply.started":"2022-10-18T17:25:30.909543Z","shell.execute_reply":"2022-10-18T17:53:10.557990Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"# Load the latest model\nmodel1.load_state_dict(torch.load('model.pt'))\nmetrics = eval_loop(model1, criterion, dl_test)\n\nprint('accuracy:', metrics['accuracy'])\nprint('f1 macro:', metrics['f1_macro'])\nprint('test loss:', metrics['loss'])","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:56:45.321401Z","iopub.execute_input":"2022-10-18T17:56:45.321912Z","iopub.status.idle":"2022-10-18T17:56:50.327967Z","shell.execute_reply.started":"2022-10-18T17:56:45.321866Z","shell.execute_reply":"2022-10-18T17:56:50.326287Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"\n\n# Unet\n**UNET** is a Conv net architecture proposed by Olaf Ronneberger, Philipp Fischer, Thomas Brox in their paper [U-Net: Convolutional Networks for Biomedical Image Segmentation\n](https://arxiv.org/pdf/1505.04597.pdf). It has been very successful in performing semantic segmantation on many benchmarks. The architecture is composed by encoder and decoder networks with a bottleneck in between. Let's see a visualization from the authors.\n\n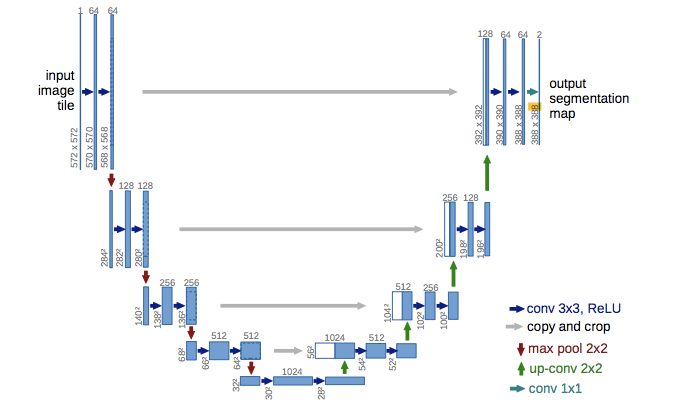 \n\n**The encoder** is composed of conv block each with two 3x3 conv layers followed by max pooling with pool size of 2, there is a total of 4 of this layers with number of filters 512, 256, 128, 64\n\n**The bottlenck** is a simple conv block of two 3x3 conv layers with 1024 filters\n\n**The decoder** consists of 4 upsampling conv block, each having tranposed conv layers with filters size of 2 and strides of 2, after upsampling skip connections are added, lastly two conv 3x3 layers are applied\n\n-------------------------------------------------------------------------------------------\n-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------\n\n# UNET with Attention\nAttention was introduced to UNET in 2018's paper [Attention U-Net: Learning Where to Look for the Pancreas](https://arxiv.org/pdf/1804.03999) by Ozan Oktay et al.\n\n**What is attention in the context of computer vision?** Attention is very often used in NLP problems as a way to make a model focus more on for example a part of a sentence. In computer vision attention is a mechanism that allows your network to look only at certain parts of image. Such a part is called a **region of interest** (ROI). Looking at only parts of an image increases computational efficiency, while adding only a small amount of parameters. Below is a diagram from the paper, as you can see attention gate is aplied before concatenation skip connetions to decoder layer.\n\n
 \n\n**Why is attention needed for UNET?** Skip connections are main characteristic of UNET, they help to preserve spatial structure in the upsampling layers. One issue with skip connections is that since they come from shallower layers of the network they extract less complex feature maps, this means that many unuseful low-level features are concatenated to the decoder, attention learns which of those features are worth taking a look at and which are just noise. The end result is a more computationaly efficient network and slighlty better performance. Let's break down the attention gate architecutre. \n","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]}},{"cell_type":"markdown","source":"## Implement of Unet","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]}},{"cell_type":"code","source":"class conv_block(nn.Module):\n \"\"\"\n Convolution Block \n \"\"\"\n def __init__(self, in_ch, out_ch):\n super(conv_block, self).__init__()\n \n self.conv = nn.Sequential(\n nn.Conv2d(in_ch, out_ch, kernel_size=3, stride=1, padding=1, bias=True),\n nn.BatchNorm2d(out_ch),\n nn.ReLU(inplace=True),\n nn.Conv2d(out_ch, out_ch, kernel_size=3, stride=1, padding=1, bias=True),\n nn.BatchNorm2d(out_ch),\n nn.ReLU(inplace=True))\n\n def forward(self, x):\n\n x = self.conv(x)\n return x\n\n\nclass up_conv(nn.Module):\n \"\"\"\n Up Convolution Block\n \"\"\"\n def __init__(self, in_ch, out_ch):\n super(up_conv, self).__init__()\n self.up = nn.Sequential(\n nn.Upsample(scale_factor=2),\n nn.Conv2d(in_ch, out_ch, kernel_size=3, stride=1, padding=1, bias=True),\n nn.BatchNorm2d(out_ch),\n nn.ReLU(inplace=True)\n )\n\n def forward(self, x):\n x = self.up(x)\n return x","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:57:45.321827Z","iopub.execute_input":"2022-10-18T17:57:45.322458Z","iopub.status.idle":"2022-10-18T17:57:45.338874Z","shell.execute_reply.started":"2022-10-18T17:57:45.322395Z","shell.execute_reply":"2022-10-18T17:57:45.337788Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"class U_Net(nn.Module):\n \"\"\"\n UNet - Basic Implementation\n Paper : https://arxiv.org/abs/1505.04597\n \"\"\"\n def __init__(self, in_ch=3, out_ch=1):\n super(U_Net, self).__init__()\n\n n1 = 64\n filters = [n1, n1 * 2, n1 * 4, n1 * 8, n1 * 16]\n \n self.Maxpool1 = nn.MaxPool2d(kernel_size=2, stride=2)\n self.Maxpool2 = nn.MaxPool2d(kernel_size=2, stride=2)\n self.Maxpool3 = nn.MaxPool2d(kernel_size=2, stride=2)\n self.Maxpool4 = nn.MaxPool2d(kernel_size=2, stride=2)\n\n self.Conv1 = conv_block(in_ch, filters[0])\n self.Conv2 = conv_block(filters[0], filters[1])\n self.Conv3 = conv_block(filters[1], filters[2])\n self.Conv4 = conv_block(filters[2], filters[3])\n self.Conv5 = conv_block(filters[3], filters[4])\n\n self.Up5 = up_conv(filters[4], filters[3])\n self.Up_conv5 = conv_block(filters[4], filters[3])\n\n self.Up4 = up_conv(filters[3], filters[2])\n self.Up_conv4 = conv_block(filters[3], filters[2])\n\n self.Up3 = up_conv(filters[2], filters[1])\n self.Up_conv3 = conv_block(filters[2], filters[1])\n\n self.Up2 = up_conv(filters[1], filters[0])\n self.Up_conv2 = conv_block(filters[1], filters[0])\n\n self.Conv = nn.Conv2d(filters[0], out_ch, kernel_size=1, stride=1, padding=0)\n\n self.active = torch.nn.Sigmoid()\n\n def forward(self, x):\n\n e1 = self.Conv1(x)\n\n e2 = self.Maxpool1(e1)\n e2 = self.Conv2(e2)\n\n e3 = self.Maxpool2(e2)\n e3 = self.Conv3(e3)\n\n e4 = self.Maxpool3(e3)\n e4 = self.Conv4(e4)\n\n e5 = self.Maxpool4(e4)\n e5 = self.Conv5(e5)\n\n d5 = self.Up5(e5)\n d5 = torch.cat((e4, d5), dim=1)\n\n d5 = self.Up_conv5(d5)\n\n d4 = self.Up4(d5)\n d4 = torch.cat((e3, d4), dim=1)\n d4 = self.Up_conv4(d4)\n\n d3 = self.Up3(d4)\n d3 = torch.cat((e2, d3), dim=1)\n d3 = self.Up_conv3(d3)\n\n d2 = self.Up2(d3)\n d2 = torch.cat((e1, d2), dim=1)\n d2 = self.Up_conv2(d2)\n\n out = self.Conv(d2)\n out = self.active(out)\n\n return out","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:57:46.334824Z","iopub.execute_input":"2022-10-18T17:57:46.335358Z","iopub.status.idle":"2022-10-18T17:57:46.354911Z","shell.execute_reply.started":"2022-10-18T17:57:46.335317Z","shell.execute_reply":"2022-10-18T17:57:46.353322Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"### Training and evaluation","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]}},{"cell_type":"code","source":"# set_seed(21)\nmodel2 = U_Net(3, 1).to(device)\noptimizer = optim.Adam(model2.parameters(), lr=0.01)\ncriterion = nn.BCELoss()\ntrain(model2, optimizer, criterion, dl_train, dl_test)","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[],"execution":{"iopub.status.busy":"2022-10-18T17:57:48.303950Z","iopub.execute_input":"2022-10-18T17:57:48.304367Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"# Load the latest model\nmodel2.load_state_dict(torch.load('model.pt'))\nmetrics = eval_loop(model2, criterion, dl_test)\n\nprint('accuracy:', metrics['accuracy'])\nprint('f1 macro:', metrics['f1_macro'])\nprint('test loss:', metrics['loss'])","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[],"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"## Attention Unet","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]}},{"cell_type":"markdown","source":"## Implement of Attention Unet","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]}},{"cell_type":"code","source":"class Attention_block(nn.Module):\n \"\"\"\n Attention Block\n \"\"\"\n\n def __init__(self, F_g, F_l, F_int):\n super(Attention_block, self).__init__()\n\n self.W_g = nn.Sequential(\n nn.Conv2d(F_l, F_int, kernel_size=1, stride=1, padding=0, bias=True),\n nn.BatchNorm2d(F_int)\n )\n\n self.W_x = nn.Sequential(\n nn.Conv2d(F_g, F_int, kernel_size=1, stride=1, padding=0, bias=True),\n nn.BatchNorm2d(F_int)\n )\n\n self.psi = nn.Sequential(\n nn.Conv2d(F_int, 1, kernel_size=1, stride=1, padding=0, bias=True),\n nn.BatchNorm2d(1),\n nn.Sigmoid()\n )\n\n self.relu = nn.ReLU(inplace=True)\n\n def forward(self, g, x):\n g1 = self.W_g(g)\n x1 = self.W_x(x)\n psi = self.relu(g1 + x1)\n psi = self.psi(psi)\n out = x * psi\n return out\n\n\nclass AttU_Net(nn.Module):\n \"\"\"\n Attention Unet implementation\n Paper: https://arxiv.org/abs/1804.03999\n \"\"\"\n def __init__(self, img_ch=3, output_ch=1):\n super(AttU_Net, self).__init__()\n\n n1 = 64\n filters = [n1, n1 * 2, n1 * 4, n1 * 8, n1 * 16]\n\n self.Maxpool1 = nn.MaxPool2d(kernel_size=2, stride=2)\n self.Maxpool2 = nn.MaxPool2d(kernel_size=2, stride=2)\n self.Maxpool3 = nn.MaxPool2d(kernel_size=2, stride=2)\n self.Maxpool4 = nn.MaxPool2d(kernel_size=2, stride=2)\n\n self.Conv1 = conv_block(img_ch, filters[0])\n self.Conv2 = conv_block(filters[0], filters[1])\n self.Conv3 = conv_block(filters[1], filters[2])\n self.Conv4 = conv_block(filters[2], filters[3])\n self.Conv5 = conv_block(filters[3], filters[4])\n\n self.Up5 = up_conv(filters[4], filters[3])\n self.Att5 = Attention_block(F_g=filters[3], F_l=filters[3], F_int=filters[2])\n self.Up_conv5 = conv_block(filters[4], filters[3])\n\n self.Up4 = up_conv(filters[3], filters[2])\n self.Att4 = Attention_block(F_g=filters[2], F_l=filters[2], F_int=filters[1])\n self.Up_conv4 = conv_block(filters[3], filters[2])\n\n self.Up3 = up_conv(filters[2], filters[1])\n self.Att3 = Attention_block(F_g=filters[1], F_l=filters[1], F_int=filters[0])\n self.Up_conv3 = conv_block(filters[2], filters[1])\n\n self.Up2 = up_conv(filters[1], filters[0])\n self.Att2 = Attention_block(F_g=filters[0], F_l=filters[0], F_int=32)\n self.Up_conv2 = conv_block(filters[1], filters[0])\n\n self.Conv = nn.Conv2d(filters[0], output_ch, kernel_size=1, stride=1, padding=0)\n\n self.active = torch.nn.Sigmoid()\n\n\n def forward(self, x):\n\n e1 = self.Conv1(x)\n\n e2 = self.Maxpool1(e1)\n e2 = self.Conv2(e2)\n\n e3 = self.Maxpool2(e2)\n e3 = self.Conv3(e3)\n\n e4 = self.Maxpool3(e3)\n e4 = self.Conv4(e4)\n\n e5 = self.Maxpool4(e4)\n e5 = self.Conv5(e5)\n\n #print(x5.shape)\n d5 = self.Up5(e5)\n #print(d5.shape)\n x4 = self.Att5(g=d5, x=e4)\n d5 = torch.cat((x4, d5), dim=1)\n d5 = self.Up_conv5(d5)\n\n d4 = self.Up4(d5)\n x3 = self.Att4(g=d4, x=e3)\n d4 = torch.cat((x3, d4), dim=1)\n d4 = self.Up_conv4(d4)\n\n d3 = self.Up3(d4)\n x2 = self.Att3(g=d3, x=e2)\n d3 = torch.cat((x2, d3), dim=1)\n d3 = self.Up_conv3(d3)\n\n d2 = self.Up2(d3)\n x1 = self.Att2(g=d2, x=e1)\n d2 = torch.cat((x1, d2), dim=1)\n d2 = self.Up_conv2(d2)\n\n out = self.Conv(d2)\n# print(out.shape)\n\n out = self.active(out)\n\n return out","metadata":{"execution":{"iopub.execute_input":"2022-10-04T15:49:02.999531Z","iopub.status.busy":"2022-10-04T15:49:02.998859Z","iopub.status.idle":"2022-10-04T15:49:03.024514Z","shell.execute_reply":"2022-10-04T15:49:03.023497Z","shell.execute_reply.started":"2022-10-04T15:49:02.999483Z"},"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"## Training and evaluation","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]}},{"cell_type":"code","source":"# set_seed(21)\nmodel3 = AttU_Net(3, 1).to(device)\noptimizer = optim.Adam(model3.parameters(), lr=0.01)\ncriterion = nn.BCELoss()\ntrain(model3, optimizer, criterion, dl_train, dl_test)","metadata":{"execution":{"iopub.execute_input":"2022-10-04T15:49:04.481974Z","iopub.status.busy":"2022-10-04T15:49:04.481507Z","iopub.status.idle":"2022-10-04T16:17:04.856173Z","shell.execute_reply":"2022-10-04T16:17:04.854915Z","shell.execute_reply.started":"2022-10-04T15:49:04.481897Z"},"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"# Load the latest model\nmodel3.load_state_dict(torch.load('model.pt'))\nmetrics = eval_loop(model3, criterion, dl_test)\n\nprint('accuracy:', metrics['accuracy'])\nprint('f1 macro:', metrics['f1_macro'])\nprint('test loss:', metrics['loss'])","metadata":{"execution":{"iopub.execute_input":"2022-10-04T16:17:04.859159Z","iopub.status.busy":"2022-10-04T16:17:04.858729Z","iopub.status.idle":"2022-10-04T16:17:10.909330Z","shell.execute_reply":"2022-10-04T16:17:10.907998Z","shell.execute_reply.started":"2022-10-04T16:17:04.859109Z"},"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"# Visualized results","metadata":{"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]}},{"cell_type":"code","source":"batchs = next(iter(dl_train))\nimages, masks = batchs\nim=images\nk=11\nimages = images.to(device)\nplt.figure(figsize=(20, 20))\nout1=model1(images)\nout1=out1.cpu().detach()\nout2=model2(images)\nout2=out2.cpu().detach()\nout3=model3(images)\nout3=out3.cpu().detach()\n\nplt.subplot(1, 3, 1)\nplt.xticks([])\nplt.yticks([])\nplt.imshow(im[k][1])\nplt.title('Original image')\n\nplt.subplot( 1, 3, 2)\nplt.xticks([])\nplt.yticks([])\n\nplt.imshow(masks[k][0])\nplt.title('Mask (Ground Truth)')\n\nplt.subplot( 1, 3, 3)\nplt.xticks([])\nplt.yticks([])\nplt.imshow(im[k][1])\nplt.imshow(masks[k][0],alpha=0.2)\nplt.title('Both')\nplt.tight_layout()\nplt.show()\n\nplt.figure(figsize=(20, 20))\nplt.subplot( 1, 3, 1)\nplt.xticks([])\nplt.yticks([])\n# plt.imshow(im[k][1])\nplt.imshow(out1[k][0])\nplt.title('Mask predicted by CNN')\n\nplt.subplot( 1, 3, 2)\nplt.xticks([])\nplt.yticks([])\n# plt.imshow(im[k][1])\nplt.imshow(out2[k][0])\nplt.title('Mask predicted by UNet')\n\nplt.subplot( 1, 3, 3)\nplt.xticks([])\nplt.yticks([])\n# plt.imshow(im[k][1])\nplt.imshow(out3[k][0])\nplt.title('Mask predicted by AttUNet')\n\nplt.tight_layout()\nplt.show()","metadata":{"execution":{"iopub.execute_input":"2022-10-04T16:22:02.532675Z","iopub.status.busy":"2022-10-04T16:22:02.532255Z","iopub.status.idle":"2022-10-04T16:22:17.385886Z","shell.execute_reply":"2022-10-04T16:22:17.384933Z","shell.execute_reply.started":"2022-10-04T16:22:02.532633Z"},"papermill":{"duration":null,"end_time":null,"exception":null,"start_time":null,"status":"pending"},"tags":[]},"execution_count":null,"outputs":[]}]}