{"metadata":{"kernelspec":{"language":"python","display_name":"Python 3","name":"python3"},"language_info":{"pygments_lexer":"ipython3","nbconvert_exporter":"python","version":"3.6.4","file_extension":".py","codemirror_mode":{"name":"ipython","version":3},"name":"python","mimetype":"text/x-python"}},"nbformat_minor":4,"nbformat":4,"cells":[{"cell_type":"markdown","source":"The work uses some ideas from next great works:\n- https://www.kaggle.com/avloss/eda-with-animation - animation technique","metadata":{}},{"cell_type":"code","source":"import warnings\nwarnings.filterwarnings('ignore')","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:02.448579Z","iopub.execute_input":"2023-10-26T15:51:02.449096Z","iopub.status.idle":"2023-10-26T15:51:02.462029Z","shell.execute_reply.started":"2023-10-26T15:51:02.44899Z","shell.execute_reply":"2023-10-26T15:51:02.4608Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"import os\nimport cv2\nimport json\nimport glob\nimport random\nimport pydicom\nimport collections\n\nimport numpy as np\nimport pandas as pd\nimport seaborn as sns\nimport os.path as osp\nimport matplotlib.pyplot as plt\nfrom pydicom.pixel_data_handlers.util import apply_voi_lut","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:02.464071Z","iopub.execute_input":"2023-10-26T15:51:02.464567Z","iopub.status.idle":"2023-10-26T15:51:03.753782Z","shell.execute_reply.started":"2023-10-26T15:51:02.464524Z","shell.execute_reply":"2023-10-26T15:51:03.752793Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"!pwd","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:03.756084Z","iopub.execute_input":"2023-10-26T15:51:03.756579Z","iopub.status.idle":"2023-10-26T15:51:04.912819Z","shell.execute_reply.started":"2023-10-26T15:51:03.75653Z","shell.execute_reply":"2023-10-26T15:51:04.911121Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"!ls ../input","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:04.915143Z","iopub.execute_input":"2023-10-26T15:51:04.915513Z","iopub.status.idle":"2023-10-26T15:51:06.015059Z","shell.execute_reply.started":"2023-10-26T15:51:04.915473Z","shell.execute_reply":"2023-10-26T15:51:06.013766Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"DATA_ROOT = osp.join(\"..\", \"input\", \"rsna-miccai-brain-tumor-radiogenomic-classification\")\nTYPES = (\"FLAIR\", \"T1w\", \"T1wCE\", \"T2w\")\ntrain_df = pd.read_csv(osp.join(DATA_ROOT, \"train_labels.csv\"))\ntrain_df","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:06.017362Z","iopub.execute_input":"2023-10-26T15:51:06.017873Z","iopub.status.idle":"2023-10-26T15:51:06.06143Z","shell.execute_reply.started":"2023-10-26T15:51:06.01782Z","shell.execute_reply":"2023-10-26T15:51:06.060374Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"plt.figure(figsize=(5, 5))\nsns.countplot(data=train_df, x=\"MGMT_value\");","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:06.062788Z","iopub.execute_input":"2023-10-26T15:51:06.063097Z","iopub.status.idle":"2023-10-26T15:51:06.259655Z","shell.execute_reply.started":"2023-10-26T15:51:06.063065Z","shell.execute_reply":"2023-10-26T15:51:06.258541Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"!ls $DATA_ROOT/train/00000","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:06.262366Z","iopub.execute_input":"2023-10-26T15:51:06.262685Z","iopub.status.idle":"2023-10-26T15:51:07.390358Z","shell.execute_reply.started":"2023-10-26T15:51:06.262652Z","shell.execute_reply":"2023-10-26T15:51:07.388714Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"def load_dicom(path):\n dicom = pydicom.read_file(path)\n data = dicom.pixel_array\n data = data - np.min(data) # (X - X_min) / (X_max - X_min)\n if np.max(data) != 0:\n data = data / np.max(data)\n data = (data * 255).astype(np.uint8)\n return data\n\n\ndef visualize_sample(\n brats21id, \n mgmt_value,\n slice_i,\n types=(\"FLAIR\", \"T1w\", \"T1wCE\", \"T2w\")\n):\n _, axes = plt.subplots(ncols=len(types), figsize=(4*len(types), 5))\n patient_path = os.path.join(DATA_ROOT, \"train\", str(brats21id).zfill(5))\n for i, t in enumerate(types):\n t_paths = sorted(\n glob.glob(os.path.join(patient_path, t, \"*\")), \n key=lambda x: int(x[:-4].split(\"-\")[-1]),\n )\n data = load_dicom(t_paths[int(len(t_paths) * slice_i)])\n axes[i].imshow(data, cmap=\"gray\")\n axes[i].set_title(f\"{t}\", fontsize=16)\n axes[i].axis(\"off\")\n\n plt.suptitle(f\"MGMT_value: {mgmt_value}\", fontsize=16)\n plt.show()","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:07.393709Z","iopub.execute_input":"2023-10-26T15:51:07.394249Z","iopub.status.idle":"2023-10-26T15:51:07.408014Z","shell.execute_reply.started":"2023-10-26T15:51:07.394188Z","shell.execute_reply":"2023-10-26T15:51:07.406686Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"import shutil\nshutil.copytree(osp.join(DATA_ROOT, \"train\", \"00000\"), \"./00000\")","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:07.40957Z","iopub.execute_input":"2023-10-26T15:51:07.409936Z","iopub.status.idle":"2023-10-26T15:51:20.318312Z","shell.execute_reply.started":"2023-10-26T15:51:07.409901Z","shell.execute_reply":"2023-10-26T15:51:20.317057Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"!tar -czf example.tar.gz ./00000","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:20.319664Z","iopub.execute_input":"2023-10-26T15:51:20.320002Z","iopub.status.idle":"2023-10-26T15:51:30.130682Z","shell.execute_reply.started":"2023-10-26T15:51:20.319968Z","shell.execute_reply":"2023-10-26T15:51:30.129471Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"!zip -qr 00000.zip ./00000","metadata":{"execution":{"iopub.status.busy":"2023-10-26T15:51:30.132422Z","iopub.execute_input":"2023-10-26T15:51:30.132805Z"},"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"for i in random.sample(range(train_df.shape[0]), 10):\n _brats21id = train_df.iloc[i][\"BraTS21ID\"]\n _mgmt_value = train_df.iloc[i][\"MGMT_value\"]\n visualize_sample(brats21id=_brats21id, mgmt_value=_mgmt_value, slice_i=0.5)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"from matplotlib import animation, rc\nrc('animation', html='jshtml')\n\n\ndef create_animation(ims):\n fig = plt.figure(figsize=(6, 6))\n plt.axis('off')\n im = plt.imshow(ims[0], cmap=\"gray\")\n def animate_func(i):\n im.set_array(ims[i])\n return [im]\n\n return animation.FuncAnimation(fig, animate_func, frames = len(ims), interval = 1000//24)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"def load_dicom_line(path):\n t_paths = sorted(\n glob.glob(os.path.join(path, \"*\")), \n key=lambda x: int(x[:-4].split(\"-\")[-1]),\n )\n images = []\n for filename in t_paths:\n data = load_dicom(filename)\n if data.max() == 0:\n continue\n images.append(data)\n return images","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"%matplotlib notebook","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"from IPython.display import clear_output\nanimations = dict()\nfor t in (\"FLAIR\", \"T1w\", \"T1wCE\", \"T2w\"):\n images = load_dicom_line(osp.join(DATA_ROOT, 'train', '00000', t))\n animations[t] = create_animation(images)\nclear_output()","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"animations['FLAIR']","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"animations['T1w']","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"animations['T1wCE']","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"animations['T2w']","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"%matplotlib inline","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"from sklearn.metrics import roc_auc_score, roc_curve, auc\n\nlist_y_true = [\n [1., 1., 1., 1., 1., 1., 0., 0., 0., 0., 0., 0.],\n [1., 1., 1., 1., 1., 1., 0., 0., 0., 0., 0., 0.],\n [1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 0.], # IMBALANCE\n]\nlist_y_pred = [\n [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5],\n [0.9, 0.9, 0.9, 0.9, 0.1, 0.9, 0.9, 0.1, 0.9, 0.1, 0.1, 0.5],\n [1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1.], # IMBALANCE\n]\n\nfor y_true, y_pred in zip(list_y_true, list_y_pred):\n fpr, tpr, _ = roc_curve(y_true, y_pred)\n roc_auc = auc(fpr, tpr)\n\n plt.figure(figsize=(5, 5))\n plt.plot(fpr, tpr, color='darkorange', lw=2, label='ROC curve (area = %0.2f)' % roc_auc)\n plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')\n plt.xlim([-0.01, 1.0])\n plt.ylim([0.0, 1.05])\n plt.xlabel('False Positive Rate')\n plt.ylabel('True Positive Rate')\n plt.title('Receiver operating characteristic example')\n plt.legend(loc=\"lower right\")\n plt.show()","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"\nSample Submission","metadata":{}},{"cell_type":"code","source":"submission = pd.read_csv(osp.join(DATA_ROOT, \"sample_submission.csv\"))\n# submission.to_csv(\"submission.csv\", index=False)\nsubmission","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"\nModeling","metadata":{}},{"cell_type":"code","source":"import time\nimport torch\n\nfrom torch import nn\nfrom tqdm.notebook import tqdm\nfrom sklearn.model_selection import StratifiedKFold\n\nfrom torch.utils import data as torch_data\nimport torch.nn.functional as torch_functional\nimport sklearn.model_selection as sk_model_selection","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"def set_seed(seed):\n random.seed(seed)\n os.environ[\"PYTHONHASHSEED\"] = str(seed)\n np.random.seed(seed)\n torch.manual_seed(seed)\n if torch.cuda.is_available():\n torch.cuda.manual_seed_all(seed)\n torch.backends.cudnn.deterministic = True\nset_seed(42)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"class DataRetriever(torch_data.Dataset):\n def __init__(self, img_paths, ids, mri_type=\"T1wCE\", targets=None, folder='train', transforms=None):\n self.ids = ids\n self.img_paths = img_paths\n self.targets = targets\n self.folder = folder\n self.transforms = transforms\n assert mri_type in TYPES\n self.mri_type = mri_type\n \n def __len__(self):\n return len(self.img_paths)\n \n def __getitem__(self, index):\n _id = self.ids[index]\n image_path = self.img_paths[index]\n X = cv2.resize(load_dicom(image_path), (256, 256)) / 255\n X = torch.tensor(X[None,...]).float()\n if self.transforms is not None:\n X = self.transforms(X)\n if self.targets is not None:\n y = torch.tensor(self.targets[index], dtype=torch.float)\n return {\"X\": X, \"y\": y, \"id\": _id}\n return {\"X\": X, \"id\": _id}","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"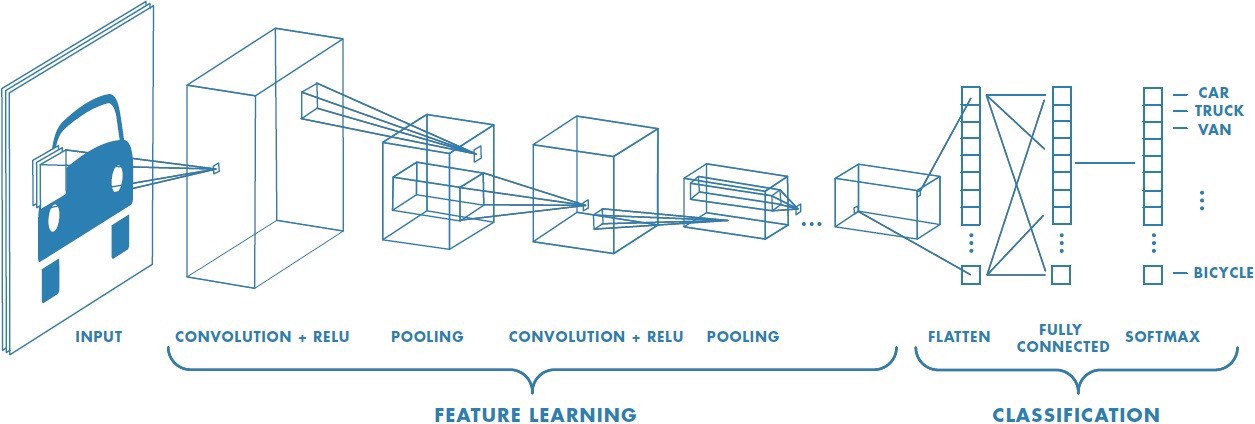","metadata":{}},{"cell_type":"code","source":"def get_valid_paths(ids, labels=None, mri_type=\"T1wCE\", folder=\"train\"):\n assert mri_type in TYPES\n all_valid_paths = []\n all_ids = []\n if labels is not None:\n all_labels = []\n for i, patient_id in enumerate(ids):\n patient_path = osp.join(DATA_ROOT, folder, str(patient_id).zfill(5))\n images_paths = sorted(\n glob.glob(osp.join(patient_path, mri_type, \"*\")),\n key=lambda x: int(x[:-4].split('-')[-1])\n )\n start, end = int(len(images_paths) * 0.25), int(len(images_paths) * 0.75)\n step = 1 if len(images_paths) < 10 else 3\n cur_valid_paths = images_paths[start:end:step]\n all_valid_paths.extend(cur_valid_paths)\n all_ids.extend([patient_id] * len(cur_valid_paths))\n if labels is not None:\n all_labels.extend([labels[i]] * len(cur_valid_paths))\n if labels is not None:\n return all_valid_paths, all_ids, all_labels\n return all_valid_paths, all_ids\n\nids_train, ids_val, y_train, y_val = \\\nsk_model_selection.train_test_split(train_df['BraTS21ID'].values,\n train_df['MGMT_value'].values,\n test_size=0.2,\n random_state=42,\n stratify=train_df[\"MGMT_value\"],\n )\nX_train, ids_train, y_train = get_valid_paths(ids_train, labels=y_train)\nX_val, ids_val, y_val = get_valid_paths(ids_val, labels=y_val)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"np.mean(y_train), np.mean(y_val)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"import torchvision.transforms as T\ntransforms = T.Compose([\n T.CenterCrop((224, 224)),\n T.Lambda(lambda x: x.float()),\n])\n\ntrain_data_retriever = DataRetriever(\n X_train,\n ids_train,\n targets=y_train,\n transforms=transforms,\n)\n\nvalid_data_retriever = DataRetriever(\n X_val, \n ids_val,\n targets=y_val,\n transforms=transforms,\n)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"plt.figure(figsize=(6, 6))\nplt.imshow(train_data_retriever[120][\"X\"].numpy()[0], cmap=\"gray\");","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"from torchvision import models\nclass Model(nn.Module):\n def __init__(self, model_name=\"efficientnet-b0\", num_classes=2):\n super().__init__()\n assert num_classes >= 2\n num_classes = 1 if num_classes == 2 else num_classes\n self.net = nn.Sequential(\n nn.Conv2d(1, 32, 3, padding=1), # (N, 32, 224, 224)\n nn.BatchNorm2d(32),\n nn.ReLU(),\n nn.Conv2d(32, 64, 3, padding=1), # (N, 64, 224, 224)\n nn.BatchNorm2d(64),\n nn.ReLU(),\n nn.MaxPool2d(2), # (N, 64, 112, 112)\n nn.Conv2d(64, 128, 3, padding=1), # (N, 128, 112, 112)\n nn.BatchNorm2d(128),\n nn.ReLU(),\n nn.Conv2d(128, 128, 3, padding=1), # (N, 128, 112, 112)\n nn.BatchNorm2d(128),\n nn.ReLU(),\n nn.MaxPool2d(2), # (N, 128, 56, 56)\n nn.Conv2d(128, 128, 3, stride=2), # (N, 128, 27, 27)\n nn.BatchNorm2d(128),\n nn.Dropout2d(p=0.3),\n nn.ReLU(),\n nn.Conv2d(128, 128, 3, stride=2), # (N, 128, 12, 12)\n nn.BatchNorm2d(128),\n nn.ReLU(),\n nn.MaxPool2d(2), # (N, 128, 6, 6)\n nn.Flatten(),\n nn.Linear(128*6*6, 1028),\n# nn.Dropout(p=0.3),\n nn.ReLU(),\n nn.Linear(1028, 512),\n nn.ReLU(),\n nn.Linear(512, num_classes)\n )\n\n def forward(self, x):\n out = self.net(x)\n return out\nmodel = Model(num_classes=2)\nmodel(torch.randn((4, 1, 224, 224)))","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"$$\\{1, 2, ..., N\\} \\rightarrow \\{1, 2, ..., N, N+1, ..., M\\}$$\n$$\\text{prev_avg} = \\frac{1}{N}\\sum_{i=1}^{N}x_{i}; \\quad \\text{avg} = \\frac{1}{M}\\sum_{i=1}^{M}x_{i} = \\frac{1}{M} \\frac{N}{N} \\sum_{i=1}^{N}x_{i} + \\frac{1}{M}\\sum_{i=N+1}^{M}x_{i}=\\frac{N}{M}\\text{prev_avg} + \\frac{1}{M}\\sum_{i=N+1}^{M}x_{i}$$","metadata":{}},{"cell_type":"code","source":"class LossMeter:\n def __init__(self):\n self.avg = 0\n self.n = 0\n\n def update(self, val):\n self.n += 1\n # incremental update\n self.avg = (self.n - 1) / self.n * self.avg + val / self.n\n\n \nclass AccMeter:\n def __init__(self):\n self.avg = 0\n self.n = 0\n \n def update(self, y_true, y_pred):\n y_true = y_true.cpu().numpy().astype(int)\n y_pred = y_pred.cpu().numpy() >= 0\n last_n = self.n\n self.n += len(y_true)\n true_count = np.sum(y_true == y_pred)\n # incremental update\n self.avg = last_n / self.n * self.avg + true_count / self.n","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"class Trainer:\n def __init__(self, model, device, optimizer, criterion, loss_meter, score_meter):\n self.model = model\n self.device = device\n self.optimizer = optimizer\n self.criterion = criterion\n self.loss_meter = loss_meter\n self.score_meter = score_meter\n \n self.best_valid_score = -np.inf\n self.n_patience = 0\n \n self.messages = {\n \"epoch\": \"[Epoch {}: {}] loss: {:.5f}, score: {:.5f}, time: {} s \",\n \"checkpoint\": \"The score improved from {:.5f} to {:.5f}. Save model to '{}'\",\n \"patience\": \"\\nValid score didn't improve last {} epochs.\"\n }\n \n def fit(self, epochs, train_loader, valid_loader, save_path, patience):\n history = {'train': {'loss': [], 'score': []},\n 'val': {'loss': [], 'score': []}}\n for n_epoch in range(1, epochs + 1):\n self.info_message(\"EPOCH: {}\", n_epoch)\n \n train_loss, train_score, train_time = self.train_epoch(train_loader)\n valid_loss, valid_score, valid_time = self.valid_epoch(valid_loader)\n history['train']['loss'].append(train_loss)\n history['train']['score'].append(train_score)\n history['val']['loss'].append(valid_loss)\n history['val']['score'].append(valid_score)\n self.info_message(\n self.messages[\"epoch\"], \"Train\", n_epoch, train_loss, train_score, train_time\n )\n \n self.info_message(\n self.messages[\"epoch\"], \"Valid\", n_epoch, valid_loss, valid_score, valid_time\n )\n\n if self.best_valid_score < valid_score:\n self.info_message(\n self.messages[\"checkpoint\"], self.best_valid_score, valid_score, save_path\n )\n self.best_valid_score = valid_score\n self.save_model(n_epoch, save_path)\n self.n_patience = 0\n else:\n self.n_patience += 1\n \n if self.n_patience >= patience:\n self.info_message(self.messages[\"patience\"], patience)\n break\n return history\n \n def train_epoch(self, train_loader):\n self.model.train()\n t = time.time()\n train_loss = self.loss_meter()\n train_score = self.score_meter()\n \n for step, batch in enumerate(train_loader, 1):\n X = batch[\"X\"].to(self.device)\n targets = batch[\"y\"].to(self.device)\n self.optimizer.zero_grad()\n outputs = self.model(X).squeeze(1)\n \n loss = self.criterion(outputs, targets)\n loss.backward()\n\n train_loss.update(loss.detach().item())\n train_score.update(targets, outputs.detach())\n\n self.optimizer.step()\n \n _loss, _score = train_loss.avg, train_score.avg\n message = 'Train Step {}/{}, train_loss: {:.5f}, train_score: {:.5f}'\n self.info_message(message, step, len(train_loader), _loss, _score, end=\"\\r\")\n \n return train_loss.avg, train_score.avg, int(time.time() - t)\n \n def valid_epoch(self, valid_loader):\n self.model.eval()\n t = time.time()\n valid_loss = self.loss_meter()\n valid_score = self.score_meter()\n\n for step, batch in enumerate(valid_loader, 1):\n with torch.no_grad():\n X = batch[\"X\"].to(self.device)\n targets = batch[\"y\"].to(self.device)\n \n outputs = self.model(X).squeeze(1)\n loss = self.criterion(outputs, targets)\n\n valid_loss.update(loss.detach().item())\n valid_score.update(targets, outputs)\n \n _loss, _score = valid_loss.avg, valid_score.avg\n message = 'Valid Step {}/{}, valid_loss: {:.5f}, valid_score: {:.5f}'\n self.info_message(message, step, len(valid_loader), _loss, _score, end=\"\\r\")\n \n return valid_loss.avg, valid_score.avg, int(time.time() - t)\n \n def save_model(self, n_epoch, save_path):\n torch.save(\n {\n \"model_state_dict\": self.model.state_dict(),\n \"optimizer_state_dict\": self.optimizer.state_dict(),\n \"best_valid_score\": self.best_valid_score,\n \"n_epoch\": n_epoch,\n },\n save_path,\n )\n \n @staticmethod\n def info_message(message, *args, end=\"\\n\"):\n print(message.format(*args), end=end)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"device = torch.device(\"cuda\" if torch.cuda.is_available() else \"cpu\")\nset_seed(42)\n\ntransforms = {\n \"train\": T.Compose([\n T.CenterCrop((224, 224)),\n T.RandomHorizontalFlip(),\n T.RandomAffine(60),\n T.Lambda(lambda x: x.float()),\n ]),\n \"val\": T.Compose([\n T.CenterCrop((224, 224)),\n T.Lambda(lambda x: x.float()),\n ])\n}\n\ntrain_data_retriever = DataRetriever(\n X_train,\n ids_train,\n targets=y_train,\n transforms=transforms['train'],\n)\n\nvalid_data_retriever = DataRetriever(\n X_val, \n ids_val,\n targets=y_val,\n transforms=transforms['val'],\n)\n\ntrain_loader = torch_data.DataLoader(\n train_data_retriever,\n batch_size=8,\n shuffle=True,\n num_workers=8,\n)\n\nvalid_loader = torch_data.DataLoader(\n valid_data_retriever,\n batch_size=8,\n shuffle=False,\n num_workers=8,\n)\n\nmodel = Model()\nmodel.to(device)\n# optimizer = torch.optim.Adam(model.parameters(), lr=0.001)\noptimizer = torch.optim.SGD(model.parameters(), lr=0.0001)\ncriterion = torch_functional.binary_cross_entropy_with_logits\ntrainer = Trainer(model, device, optimizer, criterion, LossMeter, AccMeter)\nhistory = trainer.fit(100, train_loader, valid_loader, \"best-model-0.pth\", 100)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"model = Model()\nmodel.to(device)\ntrained_weights = torch.load(f\"best-model-0.pth\")\nmodel.load_state_dict(trained_weights[\"model_state_dict\"])\nmodel.eval();","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"submission","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"submission = pd.read_csv(osp.join(DATA_ROOT, 'sample_submission.csv'))\n\nX_test, ids_test = get_valid_paths(submission['BraTS21ID'], folder='test')\n\ntest_data_retriever = DataRetriever(\n X_test, \n ids_test,\n transforms=transforms['val'],\n)\n\ntest_loader = torch_data.DataLoader(\n test_data_retriever,\n batch_size=4,\n shuffle=False,\n num_workers=8,\n)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"y_pred = []\nids = []\n\nfor e, batch in enumerate(test_loader, 1):\n print(f\"{e}/{len(test_loader)}\", end=\"\\r\")\n with torch.no_grad():\n pred = torch.sigmoid(model(batch[\"X\"].to(device))).cpu().numpy().squeeze(1)\n y_pred.extend(pred)\n ids.extend(batch[\"id\"].numpy().tolist())","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"submission = pd.DataFrame({\"BraTS21ID\": ids, \"MGMT_value\": y_pred})\nsubmission = submission.groupby('BraTS21ID').mean().reset_index()\nsubmission.to_csv(\"submission.csv\", index=False)\nsubmission","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"plt.figure(figsize=(5, 5))\nplt.hist(submission[\"MGMT_value\"]);","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"y_pred = []\nids = []\ny_true = []\n\nfor e, batch in enumerate(valid_loader, 1):\n print(f\"{e}/{len(valid_loader)}\", end=\"\\r\")\n with torch.no_grad():\n pred = torch.sigmoid(model(batch[\"X\"].to(device))).cpu().numpy().squeeze(1)\n y_pred.extend(pred)\n ids.extend(batch[\"id\"].numpy().tolist())\n y_true.extend(batch[\"y\"].numpy().tolist())","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"preds = pd.DataFrame({\"BraTS21ID\": ids, \"MGMT_value\": y_pred, \"GT\": y_true})\npreds = preds.groupby('BraTS21ID').mean().reset_index()","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"fpr, tpr, _ = roc_curve(preds[\"GT\"], preds[\"MGMT_value\"])\nroc_auc = auc(fpr, tpr)\n\nplt.figure(figsize=(5, 5))\nplt.plot(fpr, tpr, color='darkorange', lw=2, label='ROC curve (area = %0.2f)' % roc_auc)\nplt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')\nplt.xlim([-0.01, 1.0])\nplt.ylim([0.0, 1.05])\nplt.xlabel('False Positive Rate')\nplt.ylabel('True Positive Rate')\nplt.title('Receiver operating characteristic example')\nplt.legend(loc=\"lower right\")\nplt.show()","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"","metadata":{},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"!pip install --upgrade efficientnet-pytorch","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"# package_path = \"../input/efficientnet-pytorch/EfficientNet-PyTorch/EfficientNet-PyTorch-master/\"\n# import sys \n# sys.path.append(package_path)\n\nfrom efficientnet_pytorch import EfficientNet","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"ids_train, ids_val, y_train, y_val = \\\nsk_model_selection.train_test_split(train_df['BraTS21ID'].values,\n train_df['MGMT_value'].values,\n test_size=0.2,\n random_state=42,\n stratify=train_df[\"MGMT_value\"],\n )","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"class DataRetriever(torch_data.Dataset):\n def __init__(self, ids, targets=None, folder='train', transforms=None):\n self.ids = ids\n self.targets = targets\n self.folder = folder\n self.transforms = transforms\n \n def __len__(self):\n return len(self.ids)\n \n def __getitem__(self, index):\n _id = self.ids[index]\n patient_path = osp.join(DATA_ROOT, self.folder, str(_id).zfill(5))\n channels = []\n for t in (\"FLAIR\", \"T1w\", \"T1wCE\"): # \"T2w\"\n t_paths = sorted(\n glob.glob(os.path.join(patient_path, t, \"*\")), \n key=lambda x: int(x[:-4].split(\"-\")[-1]),\n )\n # start, end = int(len(t_paths) * 0.475), int(len(t_paths) * 0.525)\n x = len(t_paths)\n if x < 10:\n r = range(x)\n else:\n d = x // 10\n r = range(d, x - d, d)\n \n channel = []\n # for i in range(start, end + 1):\n for i in r:\n channel.append(cv2.resize(load_dicom(t_paths[i]), (256, 256)) / 255)\n channel = np.mean(channel, axis=0)\n channels.append(channel)\n X = torch.tensor(channels).float()\n if self.transforms is not None:\n X = self.transforms(X)\n if self.targets is not None:\n y = torch.tensor(self.targets[index], dtype=torch.float)\n return {\"X\": X, \"y\": y}\n return {\"X\": X, \"id\": index}","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"train_data_retriever = DataRetriever(\n ids_train, \n y_train, \n transforms=transforms['train'],\n)\n\nvalid_data_retriever = DataRetriever(\n ids_val, \n y_val,\n transforms=transforms['val'],\n)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"train_data_retriever[101]['X'].shape","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"plt.figure(figsize=(16, 6))\nfor i in range(3):\n plt.subplot(1, 3, i + 1)\n plt.imshow(train_data_retriever[100][\"X\"].numpy()[i], cmap=\"gray\")","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"class Model(nn.Module):\n def __init__(self, model_name=\"efficientnet-b0\", num_classes=2):\n super().__init__()\n self.net = EfficientNet.from_pretrained(model_name)\n assert num_classes >= 2\n num_classes = 1 if num_classes==2 else num_classes\n self.net._fc = nn.Sequential(\n nn.Linear(self.net._fc.in_features, 512),\n nn.ReLU(),\n nn.Linear(512, 128),\n nn.ReLU(),\n nn.Linear(128, num_classes)\n )\n\n def forward(self, x):\n out = self.net(x)\n return out\nmodel = Model(num_classes=2)\nmodel(torch.randn((4, 3, 256, 256)))","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"device = torch.device(\"cuda\" if torch.cuda.is_available() else \"cpu\")\n\ntrain_loader = torch_data.DataLoader(\n train_data_retriever,\n batch_size=8,\n shuffle=True,\n num_workers=8,\n)\n\nvalid_loader = torch_data.DataLoader(\n valid_data_retriever,\n batch_size=8,\n shuffle=False,\n num_workers=8,\n)\n\nmodel = Model()\nmodel.to(device)\noptimizer = torch.optim.Adam(model.parameters(), lr=0.001)\ncriterion = torch_functional.binary_cross_entropy_with_logits\ntrainer = Trainer(model, device, optimizer, criterion, LossMeter, AccMeter)\nhistory = trainer.fit(5, train_loader, valid_loader, \"best-model-3channels.pth\", 100)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"model = Model()\nmodel.to(device)\ntrained_weights = torch.load(\"best-model-3channels.pth\")\nmodel.load_state_dict(trained_weights[\"model_state_dict\"])\nmodel.eval();","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"submission = pd.read_csv(osp.join(DATA_ROOT, 'sample_submission.csv'))\n\ntest_data_retriever = DataRetriever(\n submission[\"BraTS21ID\"].values,\n folder='test',\n transforms=transforms['val'],\n)\n\ntest_loader = torch_data.DataLoader(\n test_data_retriever,\n batch_size=4,\n shuffle=False,\n num_workers=8,\n)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"y_pred = []\nids = []\n\nfor e, batch in enumerate(test_loader, 1):\n print(f\"{e}/{len(test_loader)}\", end=\"\\r\")\n with torch.no_grad():\n pred = torch.sigmoid(model(batch[\"X\"].to(device))).cpu().numpy().squeeze(1)\n y_pred.extend(pred)\n ids.extend(batch[\"id\"].numpy().tolist())","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"submission = pd.DataFrame({\"BraTS21ID\": ids, \"MGMT_value\": y_pred})\nsubmission.to_csv(\"submission.csv\", index=False)\nsubmission","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"plt.figure(figsize=(5, 5))\nplt.hist(submission[\"MGMT_value\"]);","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"\n3DCNN","metadata":{}},{"cell_type":"code","source":"!pip install git+https://github.com/shijianjian/EfficientNet-PyTorch-3D","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"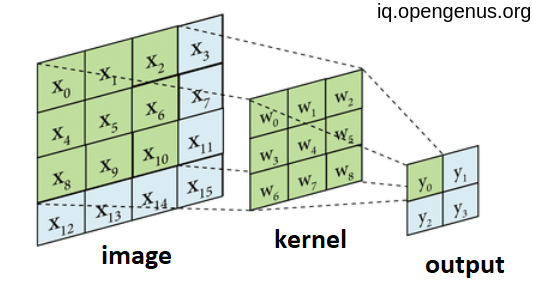","metadata":{}},{"cell_type":"markdown","source":"","metadata":{}},{"cell_type":"code","source":"from efficientnet_pytorch_3d import EfficientNet3D","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"counts = {t: [] for t in (\"FLAIR\", \"T1w\", \"T1wCE\", \"T2w\")}\npatient_paths = glob.glob(osp.join(DATA_ROOT, 'train', '*'))\nfor patient_path in patient_paths:\n for t in (\"FLAIR\", \"T1w\", \"T1wCE\", \"T2w\"):\n dicom_paths = glob.glob(osp.join(patient_path, t, '*'))\n counts[t].append(len(dicom_paths))","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"plt.hist(counts[\"FLAIR\"])","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"plt.hist(counts[\"T1w\"])","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"plt.hist(counts[\"T1wCE\"])","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"plt.hist(counts[\"T2w\"])","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"from scipy import stats\nfor k, val in counts.items():\n print(k, stats.mode(val))","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"class DepthCutter():\n def __init__(self, depth, ratio):\n self.depth = depth\n self.ratio = ratio\n assert 0 <= self.ratio <= 1\n \n def construct_3d_image(self, path):\n dicom_paths = sorted(\n glob.glob(os.path.join(path, \"*\")), \n key=lambda x: int(x[:-4].split(\"-\")[-1]),\n )\n \n if len(dicom_paths) <= self.depth:\n return self._construct_with_pad(dicom_paths)\n else:\n return self._construct_from_ratio(dicom_paths)\n \n def _construct_with_pad(self, dicom_paths):\n result = np.stack([\n cv2.resize(load_dicom(path), (256, 256))[28:-28,28:-28] / 255\n for path in dicom_paths\n ])\n pad = self.depth - result.shape[0]\n assert pad >= 0\n pad = (pad // 2, pad // 2) if pad % 2 == 0 else (pad // 2, pad // 2 + 1)\n return np.pad(result, pad_width=(pad, (0, 0), (0, 0)))\n \n def _construct_from_ratio(self, dicom_paths):\n start = int(len(dicom_paths) * (1-self.ratio) / 2)\n end = len(dicom_paths) - start\n assert abs(self.ratio - (end - start) / len(dicom_paths)) < 0.1\n dicom_paths = dicom_paths[start:end]\n if len(dicom_paths) <= self.depth:\n return self._construct_with_pad(dicom_paths)\n step = len(dicom_paths) // self.depth\n result = []\n for i in range(0, step*self.depth, step):\n result.append(cv2.resize(load_dicom(dicom_paths[i]), (256, 256))[28:-28,28:-28] / 255)\n result = np.stack(result)\n return result","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"class DataRetriever(torch_data.Dataset):\n def __init__(self, ids, targets=None,\n folder='train', transforms=None,\n depths_ratios=None\n ):\n self.depths_ratios = {\n \"FLAIR\": (50, 0.8),\n \"T1w\": (50, 0.8),\n \"T1wCE\": (50, 0.8),\n \"T2w\": (50, 0.8)\n }\n self.ids = ids\n self.targets = targets\n self.folder = folder\n self.transforms = transforms\n \n def __len__(self):\n return len(self.ids)\n \n def __getitem__(self, index):\n _id = self.ids[index]\n patient_path = osp.join(DATA_ROOT, self.folder, str(_id).zfill(5)) \n depths = None\n for t in (\"FLAIR\", \"T1w\", \"T1wCE\", \"T2w\"):\n dc = DepthCutter(*self.depths_ratios[t])\n depth = dc.construct_3d_image(osp.join(patient_path, t))\n depths = depth if depths is None else np.concatenate([depths, depth])\n X = torch.tensor(depths[None,...]).float()\n if self.transforms is not None:\n X = self.transforms(X)\n if self.targets is not None:\n y = torch.tensor(self.targets[index], dtype=torch.float)\n return {\"X\": X, \"y\": y}\n return {\"X\": X, \"id\": index}","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"train_data_retriever = DataRetriever(\n ids_train, \n y_train,\n)\n\nvalid_data_retriever = DataRetriever(\n ids_val, \n y_val, \n)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"for i in range(10):\n print(train_data_retriever[i]['X'].shape)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"xxx = train_data_retriever[0]['X'].cpu().numpy()","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"# plt.imshow(xxx[0][49], cmap='gray')","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"class Model(nn.Module):\n def __init__(self, model_name=\"efficientnet-b0\", num_classes=2):\n super().__init__()\n self.net = EfficientNet3D.from_name(model_name, in_channels=1)\n assert num_classes >= 2\n num_classes = 1 if num_classes==2 else num_classes\n self.net._fc = nn.Sequential(\n nn.Linear(self.net._fc.in_features, 512),\n nn.ReLU(),\n nn.Linear(512, 128),\n nn.ReLU(),\n nn.Linear(128, num_classes)\n )\n\n def forward(self, x):\n out = self.net(x)\n return out\nmodel = Model(num_classes=2)\nmodel(torch.randn((4, 1, 200, 200, 200)))","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"device = torch.device(\"cuda\" if torch.cuda.is_available() else \"cpu\")\n\ntrain_loader = torch_data.DataLoader(\n train_data_retriever,\n batch_size=2,\n shuffle=True,\n num_workers=8,\n)\n\nvalid_loader = torch_data.DataLoader(\n valid_data_retriever,\n batch_size=2,\n shuffle=False,\n num_workers=8,\n)\n\nmodel = Model()\nmodel.to(device)\noptimizer = torch.optim.Adam(model.parameters(), lr=0.001)\ncriterion = torch_functional.binary_cross_entropy_with_logits\ntrainer = Trainer(model, device, optimizer, criterion, LossMeter, AccMeter)\nhistory = trainer.fit(1, train_loader, valid_loader, \"best-model-3DCNN.pth\",100)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"model = Model()\nmodel.to(device)\ntrained_weights = torch.load(\"best-model-3channels.pth\")\nmodel.load_state_dict(trained_weights[\"model_state_dict\"])\nmodel.eval();","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"submission = pd.read_csv(osp.join(DATA_ROOT, 'sample_submission.csv'))\n\ntest_data_retriever = DataRetriever(\n submission[\"BraTS21ID\"].values,\n folder='test'\n)\n\ntest_loader = torch_data.DataLoader(\n test_data_retriever,\n batch_size=4,\n shuffle=False,\n num_workers=8,\n)","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"y_pred = []\nids = []\n\nfor e, batch in enumerate(test_loader, 1):\n print(f\"{e}/{len(test_loader)}\", end=\"\\r\")\n with torch.no_grad():\n pred = torch.sigmoid(model(batch[\"X\"].to(device))).cpu().numpy().squeeze(1)\n y_pred.extend(pred)\n ids.extend(batch[\"id\"].numpy().tolist())","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"submission = pd.DataFrame({\"BraTS21ID\": ids, \"MGMT_value\": y_pred})\nsubmission.to_csv(\"submission.csv\", index=False)\nsubmission","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"plt.figure(figsize=(5, 5))\nplt.hist(submission[\"MGMT_value\"], bins=10, range=(0,1));","metadata":{"trusted":true},"execution_count":null,"outputs":[]},{"cell_type":"markdown","source":"","metadata":{}},{"cell_type":"markdown","source":"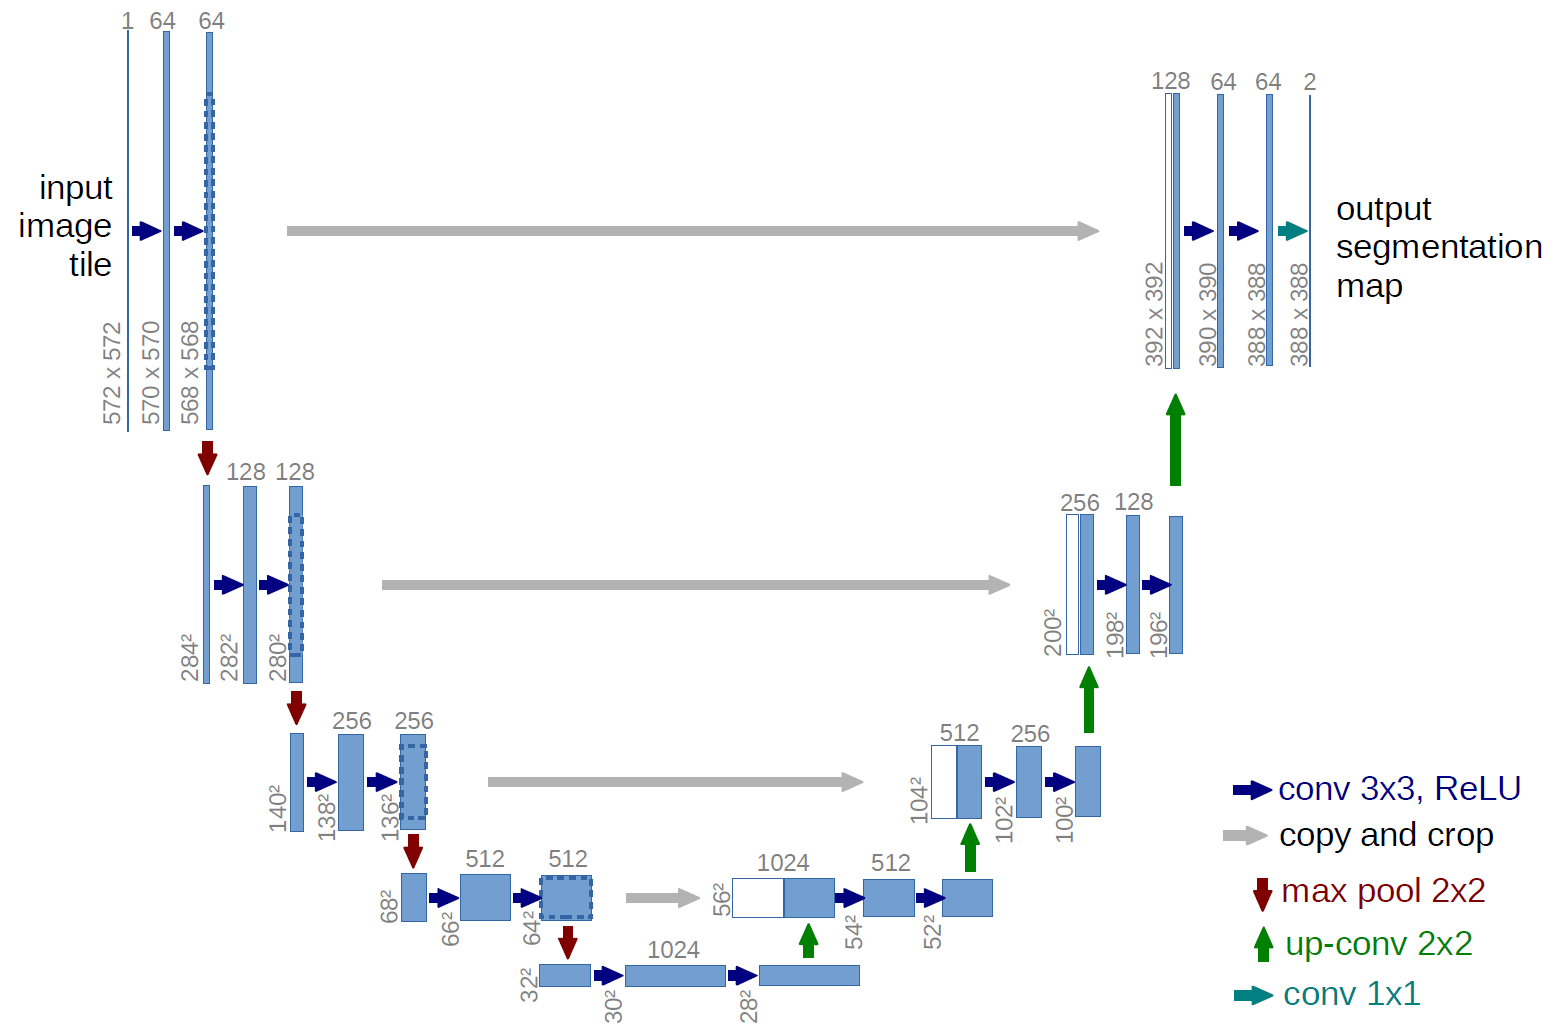","metadata":{}},{"cell_type":"code","source":"","metadata":{},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"","metadata":{},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"","metadata":{},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"","metadata":{},"execution_count":null,"outputs":[]},{"cell_type":"code","source":"","metadata":{},"execution_count":null,"outputs":[]}]}