{"cells":[{"metadata":{},"cell_type":"markdown","source":"# About this notebook\nFinetuning original models using freezing layers\n\n 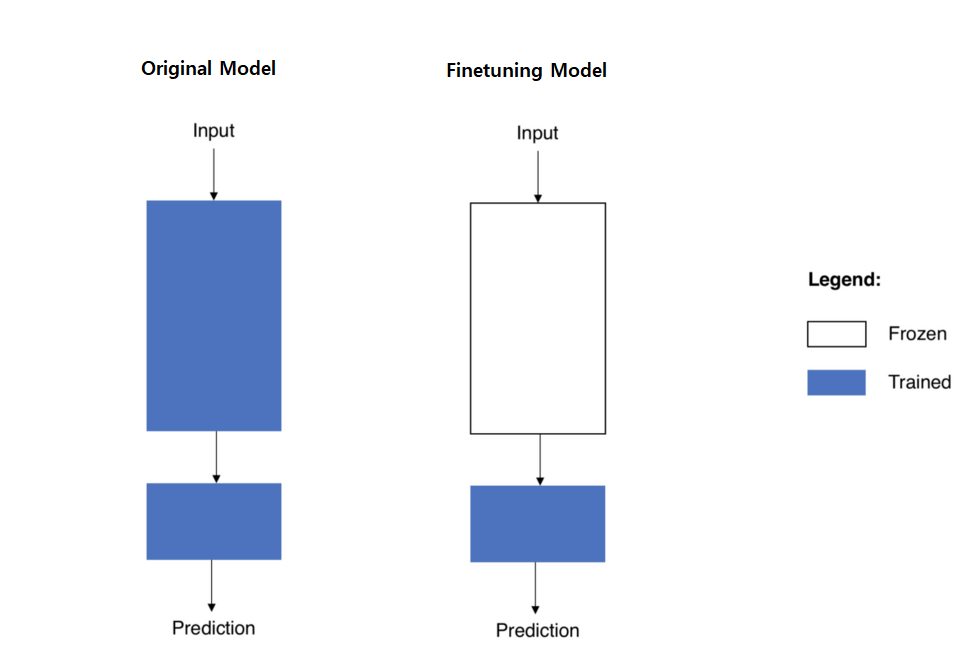 \n\n - Use resnext50_32x4d weights in [my dataset](https://www.kaggle.com/piantic/cassava-resnext50-32x4d-weights).\n - Freeze other layers\n - Train only classifier\n \n## Try more\n - Use other models(e.g. ViT, DeiT, etc.)\n - Use different Loss functions for Finetuning models\n - Use different image size(e.g. orignal - 384x384, finetuning - 512x512)\n - Train `Learning with Noisy Labels` and Finetune Original Labels\n - Train Original Labels and `Learning with Noisy Labels`\n - etc.\n\n\nIf this notebook is helpful, feel free to upvote :)\n\n\n# Updated\n- `V4` - Initial version\n\n- `V5` - Add `xm.set_rng_state(CFG.seed, device)` for reproducing results.(This requires more experimentation.)\n\n- `V6` - Add `map_location=torch.device('cpu')` to `load_state_dict` for TPU\n\n- `V7` - Test `xm.set_rng_state(CFG.seed, device)` and get same result for 1 epoch using same seed.\n\n- `V9` - Change `DeiT` model using `timm` not torch.hub and change `timm` to last version. Now, we can use `deit_base_384`.\n \n\n# [Other my notebooks for cassava]\n- Learning with Noisy Labels - Pytorch XLA(TPU)🔥\n\nhttps://www.kaggle.com/piantic/learning-with-noisy-labels-pytorch-xla-tpu\n\n- Cassava Starter using Various Loss funcs🔥\n\nhttps://www.kaggle.com/piantic/train-cassava-starter-using-various-loss-funcs\n\n- Deit, ViT + Other models for TPU🔥\n\nhttps://www.kaggle.com/piantic/cnn-or-transformer-pytorch-xla-tpu-for-cassava\n\n- Vision Transformer (ViT) : Visualize Attention Map🔥\n\nhttps://www.kaggle.com/piantic/vision-transformer-vit-visualize-attention-map\n\n- [No TTA] Cassava Resnext50_32x4d Inference🔥\n\nhttps://www.kaggle.com/piantic/no-tta-cassava-resnext50-32x4d-inference-lb0-903"},{"metadata":{},"cell_type":"markdown","source":"# Directory settings"},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# Directory settings\n# ====================================================\nimport os\n\nimport pandas as pd\n\nfrom matplotlib import pyplot as plt\nimport seaborn as sns\n\nOUTPUT_DIR = './'\nif not os.path.exists(OUTPUT_DIR):\n os.makedirs(OUTPUT_DIR)\n\nTRAIN_PATH = '../input/cassava-leaf-disease-classification/train_images'\nTEST_PATH = '../input/cassava-leaf-disease-classification/test_images'\n\nmodel_path = [\n '../input/cassava-resnext50-32x4d-weights/resnext50_32x4d_fold0.pth',\n '../input/cassava-resnext50-32x4d-weights/resnext50_32x4d_fold1.pth',\n '../input/cassava-resnext50-32x4d-weights/resnext50_32x4d_fold2.pth',\n '../input/cassava-resnext50-32x4d-weights/resnext50_32x4d_fold3.pth',\n '../input/cassava-resnext50-32x4d-weights/resnext50_32x4d_fold4.pth',\n]","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"# Data Loading"},{"metadata":{"trusted":true},"cell_type":"code","source":"os.listdir('../input/cassava-leaf-disease-classification')","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"train = pd.read_csv('../input/cassava-leaf-disease-classification/train.csv')\ntest = pd.read_csv('../input/cassava-leaf-disease-classification/sample_submission.csv')\nlabel_map = pd.read_json('../input/cassava-leaf-disease-classification/label_num_to_disease_map.json', \n orient='index')\ndisplay(label_map)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"sns.distplot(train['label'], kde=False)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"# CFG"},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# CFG\n# ====================================================\nclass CFG:\n debug=False\n apex=True\n device='TPU' # ['TPU', 'GPU']\n nprocs=1 # [1, 8]\n print_freq=100\n num_workers=4\n model_name='resnext50_32x4d' # ['vit_deit_base_patch16_384', 'vit_base_patch16_384', 'resnext50_32x4d', 'tf_efficientnet_b3_ns']\n size=512 # [224, 384, 512]\n freeze_epo = 0 # GradualWarmupSchedulerV2\n warmup_epo = 1 # GradualWarmupSchedulerV2\n cosine_epo = 3 # GradualWarmupSchedulerV2\n epochs = freeze_epo + warmup_epo + cosine_epo # [GradualWarmupSchedulerV2, n_epochs]\n scheduler='GradualWarmupSchedulerV2' # ['ReduceLROnPlateau', 'CosineAnnealingLR', 'CosineAnnealingWarmRestarts', 'GradualWarmupSchedulerV2']\n criterion='TaylorCrossEntropyLoss' # ['CrossEntropyLoss', LabelSmoothing', 'FocalLoss' 'FocalCosineLoss', 'SymmetricCrossEntropyLoss', 'BiTemperedLoss', 'TaylorCrossEntropyLoss']\n #factor=0.2 # ReduceLROnPlateau\n #patience=4 # ReduceLROnPlateau\n #eps=1e-6 # ReduceLROnPlateau\n #T_max=10 # CosineAnnealingLR\n T_0=10 # CosineAnnealingWarmRestarts\n lr=1e-4\n min_lr=1e-6\n batch_size=64 #[32, 64]\n weight_decay=1e-6\n gradient_accumulation_steps=1\n max_grad_norm=1000\n rand_augment=True\n N=3 # RandAugment\n M=11 # RandAugment\n seed=2021\n target_size=5\n target_col='label'\n n_fold=5\n trn_fold=[0] #[0, 1, 2, 3, 4]\n train=True\n smoothing=0.05\n t1=0.3 # bi-tempered-loss https://www.kaggle.com/c/cassava-leaf-disease-classification/discussion/202017\n t2=1.0 # bi-tempered-loss https://www.kaggle.com/c/cassava-leaf-disease-classification/discussion/202017\n freeze=True\n \nif CFG.debug:\n CFG.epochs = 1\n train = train.sample(n=1000, random_state=CFG.seed).reset_index(drop=True)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"if CFG.device == 'TPU':\n import os\n os.system('curl https://raw.githubusercontent.com/pytorch/xla/master/contrib/scripts/env-setup.py -o pytorch-xla-env-setup.py')\n os.system('python pytorch-xla-env-setup.py --version nightly --apt-packages libomp5 libopenblas-dev')\n os.system('export XLA_USE_BF16=1')\n os.system('export XLA_TENSOR_ALLOCATOR_MAXSIZE=100000000')\n import torch_xla.core.xla_model as xm\n import torch_xla.distributed.parallel_loader as pl\n import torch_xla.distributed.xla_multiprocessing as xmp\n CFG.lr = CFG.lr * CFG.nprocs\n CFG.batch_size = CFG.batch_size // CFG.nprocs\n \nif CFG.scheduler == 'GradualWarmupSchedulerV2': \n !pip install git+https://github.com/ildoonet/pytorch-gradual-warmup-lr.git > /dev/null","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"# Library"},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# Library\n# ====================================================\nimport sys\nsys.path.append('../input/pytorch-image-models/pytorch-image-models-master')\n\nimport os\nimport math\nimport time\nimport random\nimport shutil\nfrom pathlib import Path\nfrom contextlib import contextmanager\nfrom collections import defaultdict, Counter\n\nimport scipy as sp\nimport numpy as np\nimport pandas as pd\n\nfrom sklearn import preprocessing\nfrom sklearn.metrics import accuracy_score\nfrom sklearn.model_selection import StratifiedKFold\n\nfrom tqdm.auto import tqdm\nfrom functools import partial\n\nimport cv2\nfrom PIL import Image\n\nimport torch\nimport torch.nn as nn\nimport torch.nn.functional as F\nfrom torch.optim import Adam, SGD\nimport torchvision.models as models\nfrom torch.nn.parameter import Parameter\nfrom torch.utils.data import DataLoader, Dataset, WeightedRandomSampler\nfrom torch.optim.lr_scheduler import CosineAnnealingWarmRestarts, CosineAnnealingLR, ReduceLROnPlateau\nfrom warmup_scheduler import GradualWarmupScheduler\n\nimport albumentations as A\nfrom albumentations.pytorch import ToTensorV2\nfrom albumentations import ImageOnlyTransform\n\nimport timm\n\nimport warnings \nwarnings.filterwarnings('ignore')\n\n\n# ======================================\n# Device - TPU or GPU\n# ======================================\n\nif CFG.device == 'TPU':\n import ignite.distributed as idist\nelif CFG.device == 'GPU' and CFG.apex:\n from torch.cuda.amp import autocast, GradScaler\n\ndevice = torch.device('cuda' if torch.cuda.is_available() else 'cpu')","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"timm.__version__","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# If you want to use DeiT, please check timm version>=0.3.2\nassert timm.__version__ >= \"0.3.2\"","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"# Utils"},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# Utils\n# ====================================================\n\ndef get_score(y_true, y_pred):\n return accuracy_score(y_true, y_pred)\n\n\n@contextmanager\ndef timer(name):\n t0 = time.time()\n LOGGER.info(f'[{name}] start')\n yield\n LOGGER.info(f'[{name}] done in {time.time() - t0:.0f} s.')\n\n\ndef init_logger(log_file=OUTPUT_DIR+'train.log'):\n from logging import getLogger, INFO, FileHandler, Formatter, StreamHandler\n logger = getLogger(__name__)\n logger.setLevel(INFO)\n handler1 = StreamHandler()\n handler1.setFormatter(Formatter(\"%(message)s\"))\n handler2 = FileHandler(filename=log_file)\n handler2.setFormatter(Formatter(\"%(message)s\"))\n logger.addHandler(handler1)\n logger.addHandler(handler2)\n return logger\n\nLOGGER = init_logger()\n\n\ndef seed_torch(seed=2021):\n random.seed(seed)\n os.environ['PYTHONHASHSEED'] = str(seed)\n np.random.seed(seed)\n torch.manual_seed(seed)\n torch.cuda.manual_seed(seed)\n torch.backends.cudnn.deterministic = True\n\nseed_torch(seed=CFG.seed)","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"# CV split"},{"metadata":{"trusted":true},"cell_type":"code","source":"folds = train.copy()\nFold = StratifiedKFold(n_splits=CFG.n_fold, shuffle=True, random_state=CFG.seed)\nfor n, (train_index, val_index) in enumerate(Fold.split(folds, folds[CFG.target_col])):\n folds.loc[val_index, 'fold'] = int(n)\nfolds['fold'] = folds['fold'].astype(int)\nprint(folds.groupby(['fold', CFG.target_col]).size())","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"# Dataset"},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# Dataset - Add teacher_labels\n# ====================================================\nclass TrainDataset(Dataset):\n def __init__(self, df, transform=None):\n self.df = df\n self.file_names = df['image_id'].values\n self.labels = df['label'].values\n self.transform = transform\n \n def __len__(self):\n return len(self.df)\n\n def __getitem__(self, idx):\n file_name = self.file_names[idx]\n file_path = f'{TRAIN_PATH}/{file_name}'\n image = cv2.imread(file_path)\n image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)\n if self.transform:\n augmented = self.transform(image=image)\n image = augmented['image']\n label = torch.tensor(self.labels[idx]).long()\n return image, label\n \n return image, label","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"from matplotlib import pyplot as plt\n\ntrain_dataset = TrainDataset(folds, transform=None)\n\nfor i in range(1):\n image, label = train_dataset[i]\n plt.imshow(image)\n plt.title(f'label: {label}')\n plt.show() ","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"# Transforms"},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# Transforms\n# ====================================================\ndef get_transforms(*, data):\n \n if data == 'train':\n return A.Compose([\n A.RandomResizedCrop(CFG.size, CFG.size),\n A.Transpose(p=0.5),\n A.HorizontalFlip(p=0.5),\n A.VerticalFlip(p=0.5),\n A.ShiftScaleRotate(p=0.5),\n A.Normalize(\n mean=[0.485, 0.456, 0.406],\n std=[0.229, 0.224, 0.225],\n ),\n ToTensorV2(),\n ])\n\n elif data == 'valid':\n return A.Compose([\n A.Resize(CFG.size, CFG.size),\n A.Normalize(\n mean=[0.485, 0.456, 0.406],\n std=[0.229, 0.224, 0.225],\n ),\n ToTensorV2(),\n ])","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"train_dataset = TrainDataset(folds, transform=get_transforms(data='train'))\n\nfor i in range(3):\n image, label = train_dataset[i]\n plt.imshow(image[0])\n plt.title(f'label: {label}')\n plt.show() ","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# MODEL\n# ====================================================\nclass CustomResNext(nn.Module):\n def __init__(self, model_name=CFG.model_name, pretrained=False):\n super().__init__()\n self.model = timm.create_model(model_name, pretrained=pretrained)\n n_features = self.model.fc.in_features\n self.model.fc = nn.Linear(n_features, CFG.target_size)\n\n def forward(self, x):\n x = self.model(x)\n return x\n \n def freeze(self):\n # To freeze the residual layers\n for param in self.model.parameters():\n param.requires_grad = False\n\n for param in self.model.fc.parameters():\n param.requires_grad = True\n \n def unfreeze(self):\n # Unfreeze all layers\n for param in self.model.parameters():\n param.requires_grad = True\n \n\nclass CustomEfficientNet(nn.Module):\n def __init__(self, model_name=CFG.model_name, pretrained=False):\n super().__init__()\n self.model = timm.create_model(CFG.model_name, pretrained=pretrained)\n n_features = self.model.classifier.in_features\n self.model.classifier = nn.Linear(n_features, CFG.target_size)\n\n def forward(self, x):\n x = self.model(x)\n return x\n \n def freeze(self):\n # To freeze the residual layers\n for param in self.model.parameters():\n param.requires_grad = False\n\n for param in self.model.classifier.parameters():\n param.requires_grad = True\n \n def unfreeze(self):\n # Unfreeze all layers\n for param in self.model.parameters():\n param.requires_grad = True\n \n \nclass CustomDeiT(nn.Module):\n def __init__(self, model_name=CFG.model_name, pretrained=False):\n super().__init__()\n self.model = timm.create_model(model_name, pretrained=pretrained)\n n_features = self.model.head.in_features\n self.model.head = nn.Linear(n_features, CFG.target_size)\n\n def forward(self, x):\n x = self.model(x)\n return x\n \n def freeze(self):\n # To freeze the residual layers\n for param in self.model.parameters():\n param.requires_grad = False\n\n for param in self.model.head.parameters():\n param.requires_grad = True\n \n def unfreeze(self):\n # Unfreeze all layers\n for param in self.model.parameters():\n param.requires_grad = True\n\n \nclass CustomViT(nn.Module):\n def __init__(self, model_name=CFG.model_name, pretrained=False):\n super().__init__()\n self.model = timm.create_model(model_name, pretrained=pretrained)\n n_features = self.model.head.in_features\n self.model.head = nn.Linear(n_features, CFG.target_size)\n\n def forward(self, x):\n x = self.model(x)\n return x\n \n def freeze(self):\n # To freeze the residual layers\n for param in self.model.parameters():\n param.requires_grad = False\n\n for param in self.model.head.parameters():\n param.requires_grad = True\n \n def unfreeze(self):\n # Unfreeze all layers\n for param in self.model.parameters():\n param.requires_grad = True","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"def load_state(model_path, model):\n try: # single GPU model_file\n model.load_state_dict(torch.load(model_path, map_location=torch.device('cpu'))['model'], strict=True)\n state_dict = torch.load(model_path)['model']\n except: # multi GPU model_file\n state_dict = torch.load(model_path, map_location=torch.device('cpu'))['model']\n state_dict = {k[7:] if k.startswith('module.') else k: state_dict[k] for k in state_dict.keys()}\n\n return state_dict","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"if CFG.model_name=='vit_deit_base_patch16_224':\n model = CustomDeiT(model_name=CFG.model_name, pretrained=False)\nelif CFG.model_name=='vit_base_patch16_384':\n model = CustomViT(model_name=CFG.model_name, pretrained=False)\nelif CFG.model_name=='resnext50_32x4d':\n model = CustomResNext(CFG.model_name, pretrained=False)\nelif CFG.model_name=='tf_efficientnet_b3_ns':\n model = CustomEfficientNet(CFG.model_name, pretrained=False)\n \n# ===============================\n# Freeze layers\n# ===============================\nif CFG.freeze:\n model.load_state_dict(load_state(model_path[0], model))\n model.freeze()\n\ntrain_dataset = TrainDataset(folds, transform=get_transforms(data='train'))\ntrain_loader = DataLoader(train_dataset, batch_size=4, shuffle=True,\n num_workers=4, pin_memory=True, drop_last=True)\n\nfor image, label in train_loader:\n output = model(image)\n print(output)\n break","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"# Criterion"},{"metadata":{},"cell_type":"markdown","source":"## Label Smoothing"},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# Label Smoothing\n# ====================================================\nclass LabelSmoothingLoss(nn.Module): \n def __init__(self, classes=5, smoothing=0.0, dim=-1): \n super(LabelSmoothingLoss, self).__init__() \n self.confidence = 1.0 - smoothing \n self.smoothing = smoothing \n self.cls = classes \n self.dim = dim \n def forward(self, pred, target): \n pred = pred.log_softmax(dim=self.dim) \n with torch.no_grad():\n true_dist = torch.zeros_like(pred) \n true_dist.fill_(self.smoothing / (self.cls - 1)) \n true_dist.scatter_(1, target.data.unsqueeze(1), self.confidence) \n return torch.mean(torch.sum(-true_dist * pred, dim=self.dim))","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"## Focal Loss"},{"metadata":{"trusted":true},"cell_type":"code","source":"class FocalLoss(nn.Module):\n def __init__(self, alpha=1, gamma=2, reduce=True):\n super(FocalLoss, self).__init__()\n self.alpha = alpha\n self.gamma = gamma\n self.reduce = reduce\n\n def forward(self, inputs, targets):\n BCE_loss = nn.CrossEntropyLoss()(inputs, targets)\n\n pt = torch.exp(-BCE_loss)\n F_loss = self.alpha * (1-pt)**self.gamma * BCE_loss\n\n if self.reduce:\n return torch.mean(F_loss)\n else:\n return F_loss","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"## FocalCosineLoss"},{"metadata":{"trusted":true},"cell_type":"code","source":"class FocalCosineLoss(nn.Module):\n def __init__(self, alpha=1, gamma=2, xent=.1):\n super(FocalCosineLoss, self).__init__()\n self.alpha = alpha\n self.gamma = gamma\n\n self.xent = xent\n\n self.y = torch.Tensor([1]).cuda()\n\n def forward(self, input, target, reduction=\"mean\"):\n cosine_loss = F.cosine_embedding_loss(input, F.one_hot(target, num_classes=input.size(-1)), self.y, reduction=reduction)\n\n cent_loss = F.cross_entropy(F.normalize(input), target, reduce=False)\n pt = torch.exp(-cent_loss)\n focal_loss = self.alpha * (1-pt)**self.gamma * cent_loss\n\n if reduction == \"mean\":\n focal_loss = torch.mean(focal_loss)\n\n return cosine_loss + self.xent * focal_loss","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"## SymmetricCrossEntropy"},{"metadata":{"trusted":true},"cell_type":"code","source":"class SymmetricCrossEntropy(nn.Module):\n\n def __init__(self, alpha=0.1, beta=1.0, num_classes=5):\n super(SymmetricCrossEntropy, self).__init__()\n self.alpha = alpha\n self.beta = beta\n self.num_classes = num_classes\n\n def forward(self, logits, targets, reduction='mean'):\n onehot_targets = torch.eye(self.num_classes)[targets].cuda()\n ce_loss = F.cross_entropy(logits, targets, reduction=reduction)\n rce_loss = (-onehot_targets*logits.softmax(1).clamp(1e-7, 1.0).log()).sum(1)\n if reduction == 'mean':\n rce_loss = rce_loss.mean()\n elif reduction == 'sum':\n rce_loss = rce_loss.sum()\n return self.alpha * ce_loss + self.beta * rce_loss","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"## Bi-Tempered-Loss"},{"metadata":{"trusted":true},"cell_type":"code","source":"def log_t(u, t):\n \"\"\"Compute log_t for `u'.\"\"\"\n if t==1.0:\n return u.log()\n else:\n return (u.pow(1.0 - t) - 1.0) / (1.0 - t)\n\ndef exp_t(u, t):\n \"\"\"Compute exp_t for `u'.\"\"\"\n if t==1:\n return u.exp()\n else:\n return (1.0 + (1.0-t)*u).relu().pow(1.0 / (1.0 - t))\n\ndef compute_normalization_fixed_point(activations, t, num_iters):\n\n \"\"\"Returns the normalization value for each example (t > 1.0).\n Args:\n activations: A multi-dimensional tensor with last dimension `num_classes`.\n t: Temperature 2 (> 1.0 for tail heaviness).\n num_iters: Number of iterations to run the method.\n Return: A tensor of same shape as activation with the last dimension being 1.\n \"\"\"\n mu, _ = torch.max(activations, -1, keepdim=True)\n normalized_activations_step_0 = activations - mu\n\n normalized_activations = normalized_activations_step_0\n\n for _ in range(num_iters):\n logt_partition = torch.sum(\n exp_t(normalized_activations, t), -1, keepdim=True)\n normalized_activations = normalized_activations_step_0 * \\\n logt_partition.pow(1.0-t)\n\n logt_partition = torch.sum(\n exp_t(normalized_activations, t), -1, keepdim=True)\n normalization_constants = - log_t(1.0 / logt_partition, t) + mu\n\n return normalization_constants\n\ndef compute_normalization_binary_search(activations, t, num_iters):\n\n \"\"\"Returns the normalization value for each example (t < 1.0).\n Args:\n activations: A multi-dimensional tensor with last dimension `num_classes`.\n t: Temperature 2 (< 1.0 for finite support).\n num_iters: Number of iterations to run the method.\n Return: A tensor of same rank as activation with the last dimension being 1.\n \"\"\"\n\n mu, _ = torch.max(activations, -1, keepdim=True)\n normalized_activations = activations - mu\n\n effective_dim = \\\n torch.sum(\n (normalized_activations > -1.0 / (1.0-t)).to(torch.int32),\n dim=-1, keepdim=True).to(activations.dtype)\n\n shape_partition = activations.shape[:-1] + (1,)\n lower = torch.zeros(shape_partition, dtype=activations.dtype, device=activations.device)\n upper = -log_t(1.0/effective_dim, t) * torch.ones_like(lower)\n\n for _ in range(num_iters):\n logt_partition = (upper + lower)/2.0\n sum_probs = torch.sum(\n exp_t(normalized_activations - logt_partition, t),\n dim=-1, keepdim=True)\n update = (sum_probs < 1.0).to(activations.dtype)\n lower = torch.reshape(\n lower * update + (1.0-update) * logt_partition,\n shape_partition)\n upper = torch.reshape(\n upper * (1.0 - update) + update * logt_partition,\n shape_partition)\n\n logt_partition = (upper + lower)/2.0\n return logt_partition + mu\n\nclass ComputeNormalization(torch.autograd.Function):\n \"\"\"\n Class implementing custom backward pass for compute_normalization. See compute_normalization.\n \"\"\"\n @staticmethod\n def forward(ctx, activations, t, num_iters):\n if t < 1.0:\n normalization_constants = compute_normalization_binary_search(activations, t, num_iters)\n else:\n normalization_constants = compute_normalization_fixed_point(activations, t, num_iters)\n\n ctx.save_for_backward(activations, normalization_constants)\n ctx.t=t\n return normalization_constants\n\n @staticmethod\n def backward(ctx, grad_output):\n activations, normalization_constants = ctx.saved_tensors\n t = ctx.t\n normalized_activations = activations - normalization_constants \n probabilities = exp_t(normalized_activations, t)\n escorts = probabilities.pow(t)\n escorts = escorts / escorts.sum(dim=-1, keepdim=True)\n grad_input = escorts * grad_output\n \n return grad_input, None, None\n\ndef compute_normalization(activations, t, num_iters=5):\n \"\"\"Returns the normalization value for each example. \n Backward pass is implemented.\n Args:\n activations: A multi-dimensional tensor with last dimension `num_classes`.\n t: Temperature 2 (> 1.0 for tail heaviness, < 1.0 for finite support).\n num_iters: Number of iterations to run the method.\n Return: A tensor of same rank as activation with the last dimension being 1.\n \"\"\"\n return ComputeNormalization.apply(activations, t, num_iters)\n\ndef tempered_sigmoid(activations, t, num_iters = 5):\n \"\"\"Tempered sigmoid function.\n Args:\n activations: Activations for the positive class for binary classification.\n t: Temperature tensor > 0.0.\n num_iters: Number of iterations to run the method.\n Returns:\n A probabilities tensor.\n \"\"\"\n internal_activations = torch.stack([activations,\n torch.zeros_like(activations)],\n dim=-1)\n internal_probabilities = tempered_softmax(internal_activations, t, num_iters)\n return internal_probabilities[..., 0]\n\n\ndef tempered_softmax(activations, t, num_iters=5):\n \"\"\"Tempered softmax function.\n Args:\n activations: A multi-dimensional tensor with last dimension `num_classes`.\n t: Temperature > 1.0.\n num_iters: Number of iterations to run the method.\n Returns:\n A probabilities tensor.\n \"\"\"\n if t == 1.0:\n return activations.softmax(dim=-1)\n\n normalization_constants = compute_normalization(activations, t, num_iters)\n return exp_t(activations - normalization_constants, t)\n\ndef bi_tempered_binary_logistic_loss(activations,\n labels,\n t1,\n t2,\n label_smoothing = 0.0,\n num_iters=5,\n reduction='mean'):\n\n \"\"\"Bi-Tempered binary logistic loss.\n Args:\n activations: A tensor containing activations for class 1.\n labels: A tensor with shape as activations, containing probabilities for class 1\n t1: Temperature 1 (< 1.0 for boundedness).\n t2: Temperature 2 (> 1.0 for tail heaviness, < 1.0 for finite support).\n label_smoothing: Label smoothing\n num_iters: Number of iterations to run the method.\n Returns:\n A loss tensor.\n \"\"\"\n internal_activations = torch.stack([activations,\n torch.zeros_like(activations)],\n dim=-1)\n internal_labels = torch.stack([labels.to(activations.dtype),\n 1.0 - labels.to(activations.dtype)],\n dim=-1)\n return bi_tempered_logistic_loss(internal_activations, \n internal_labels,\n t1,\n t2,\n label_smoothing = label_smoothing,\n num_iters = num_iters,\n reduction = reduction)\n\ndef bi_tempered_logistic_loss(activations,\n labels,\n t1,\n t2,\n label_smoothing=0.0,\n num_iters=5,\n reduction = 'mean'):\n\n \"\"\"Bi-Tempered Logistic Loss.\n Args:\n activations: A multi-dimensional tensor with last dimension `num_classes`.\n labels: A tensor with shape and dtype as activations (onehot), \n or a long tensor of one dimension less than activations (pytorch standard)\n t1: Temperature 1 (< 1.0 for boundedness).\n t2: Temperature 2 (> 1.0 for tail heaviness, < 1.0 for finite support).\n label_smoothing: Label smoothing parameter between [0, 1). Default 0.0.\n num_iters: Number of iterations to run the method. Default 5.\n reduction: ``'none'`` | ``'mean'`` | ``'sum'``. Default ``'mean'``.\n ``'none'``: No reduction is applied, return shape is shape of\n activations without the last dimension.\n ``'mean'``: Loss is averaged over minibatch. Return shape (1,)\n ``'sum'``: Loss is summed over minibatch. Return shape (1,)\n Returns:\n A loss tensor.\n \"\"\"\n\n if len(labels.shape) 0:\n num_classes = labels_onehot.shape[-1]\n labels_onehot = ( 1 - label_smoothing * num_classes / (num_classes - 1) ) \\\n * labels_onehot + \\\n label_smoothing / (num_classes - 1)\n\n probabilities = tempered_softmax(activations, t2, num_iters)\n\n loss_values = labels_onehot * log_t(labels_onehot + 1e-10, t1) \\\n - labels_onehot * log_t(probabilities, t1) \\\n - labels_onehot.pow(2.0 - t1) / (2.0 - t1) \\\n + probabilities.pow(2.0 - t1) / (2.0 - t1)\n loss_values = loss_values.sum(dim = -1) #sum over classes\n\n if reduction == 'none':\n return loss_values\n if reduction == 'sum':\n return loss_values.sum()\n if reduction == 'mean':\n return loss_values.mean()","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"class BiTemperedLogisticLoss(nn.Module): \n def __init__(self, t1, t2, smoothing=0.0): \n super(BiTemperedLogisticLoss, self).__init__() \n self.t1 = t1\n self.t2 = t2\n self.smoothing = smoothing\n def forward(self, logit_label, truth_label):\n loss_label = bi_tempered_logistic_loss(\n logit_label, truth_label,\n t1=self.t1, t2=self.t2,\n label_smoothing=self.smoothing,\n reduction='none'\n )\n \n loss_label = loss_label.mean()\n return loss_label","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"## TaylorCrossEntropyLoss with LabelSmoothing"},{"metadata":{"trusted":true},"cell_type":"code","source":"class TaylorSoftmax(nn.Module):\n '''\n This is the autograd version\n '''\n def __init__(self, dim=1, n=2):\n super(TaylorSoftmax, self).__init__()\n assert n % 2 == 0\n self.dim = dim\n self.n = n\n\n def forward(self, x):\n '''\n usage similar to nn.Softmax:\n >>> mod = TaylorSoftmax(dim=1, n=4)\n >>> inten = torch.randn(1, 32, 64, 64)\n >>> out = mod(inten)\n '''\n fn = torch.ones_like(x)\n denor = 1.\n for i in range(1, self.n+1):\n denor *= i\n fn = fn + x.pow(i) / denor\n out = fn / fn.sum(dim=self.dim, keepdims=True)\n return out\n\n\nclass TaylorCrossEntropyLoss(nn.Module):\n\n def __init__(self, n=2, ignore_index=-1, reduction='mean', smoothing=0.2):\n super(TaylorCrossEntropyLoss, self).__init__()\n assert n % 2 == 0\n self.taylor_softmax = TaylorSoftmax(dim=1, n=n)\n self.reduction = reduction\n self.ignore_index = ignore_index\n self.lab_smooth = LabelSmoothingLoss(CFG.target_size, smoothing=smoothing)\n\n def forward(self, logits, labels):\n log_probs = self.taylor_softmax(logits).log()\n loss = self.lab_smooth(log_probs, labels)\n return loss","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"# Helper functions"},{"metadata":{},"cell_type":"markdown","source":"## Scheduler"},{"metadata":{"trusted":true},"cell_type":"code","source":"class GradualWarmupSchedulerV2(GradualWarmupScheduler):\n def __init__(self, optimizer, multiplier, total_epoch, after_scheduler=None):\n super(GradualWarmupSchedulerV2, self).__init__(optimizer, multiplier, total_epoch, after_scheduler)\n def get_lr(self):\n if self.last_epoch > self.total_epoch:\n if self.after_scheduler:\n if not self.finished:\n self.after_scheduler.base_lrs = [base_lr * self.multiplier for base_lr in self.base_lrs]\n self.finished = True\n return self.after_scheduler.get_lr()\n return [base_lr * self.multiplier for base_lr in self.base_lrs]\n if self.multiplier == 1.0:\n return [base_lr * (float(self.last_epoch) / self.total_epoch) for base_lr in self.base_lrs]\n else:\n return [base_lr * ((self.multiplier - 1.) * self.last_epoch / self.total_epoch + 1.) for base_lr in self.base_lrs]","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# Helper functions\n# ====================================================\nclass AverageMeter(object):\n \"\"\"Computes and stores the average and current value\"\"\"\n def __init__(self):\n self.reset()\n\n def reset(self):\n self.val = 0\n self.avg = 0\n self.sum = 0\n self.count = 0\n\n def update(self, val, n=1):\n self.val = val\n self.sum += val * n\n self.count += n\n self.avg = self.sum / self.count\n\n\ndef asMinutes(s):\n m = math.floor(s / 60)\n s -= m * 60\n return '%dm %ds' % (m, s)\n\n\ndef timeSince(since, percent):\n now = time.time()\n s = now - since\n es = s / (percent)\n rs = es - s\n return '%s (remain %s)' % (asMinutes(s), asMinutes(rs))\n\n\ndef train_fn(train_loader, model, criterion, optimizer, epoch, scheduler, device):\n if CFG.device == 'GPU':\n scaler = GradScaler()\n batch_time = AverageMeter()\n data_time = AverageMeter()\n losses = AverageMeter()\n scores = AverageMeter()\n # switch to train mode\n model.train()\n start = end = time.time()\n global_step = 0\n for step, (images, labels) in enumerate(train_loader):\n # measure data loading time\n data_time.update(time.time() - end)\n images = images.to(device)\n labels = labels.to(device)\n batch_size = labels.size(0)\n if CFG.device == 'GPU':\n with autocast():\n y_preds = model(images)\n loss = criterion(y_preds, labels)\n # record loss\n losses.update(loss.item(), batch_size)\n if CFG.gradient_accumulation_steps > 1:\n loss = loss / CFG.gradient_accumulation_steps\n scaler.scale(loss).backward()\n grad_norm = torch.nn.utils.clip_grad_norm_(model.parameters(), CFG.max_grad_norm)\n if (step + 1) % CFG.gradient_accumulation_steps == 0:\n scaler.step(optimizer)\n scaler.update()\n optimizer.zero_grad()\n global_step += 1\n elif CFG.device == 'TPU':\n y_preds = model(images)\n loss = criterion(y_preds, labels)\n # record loss\n losses.update(loss.item(), batch_size)\n if CFG.gradient_accumulation_steps > 1:\n loss = loss / CFG.gradient_accumulation_steps\n loss.backward()\n grad_norm = torch.nn.utils.clip_grad_norm_(model.parameters(), CFG.max_grad_norm)\n if (step + 1) % CFG.gradient_accumulation_steps == 0:\n xm.optimizer_step(optimizer, barrier=True)\n optimizer.zero_grad()\n global_step += 1\n # measure elapsed time\n batch_time.update(time.time() - end)\n end = time.time()\n if CFG.device == 'GPU':\n if step % CFG.print_freq == 0 or step == (len(train_loader)-1):\n print('Epoch: [{0}][{1}/{2}] '\n 'Data {data_time.val:.3f} ({data_time.avg:.3f}) '\n 'Elapsed {remain:s} '\n 'Loss: {loss.val:.4f}({loss.avg:.4f}) '\n 'Grad: {grad_norm:.4f} '\n #'LR: {lr:.6f} '\n .format(\n epoch+1, step, len(train_loader), batch_time=batch_time,\n data_time=data_time, loss=losses,\n remain=timeSince(start, float(step+1)/len(train_loader)),\n grad_norm=grad_norm,\n #lr=scheduler.get_lr()[0],\n ))\n elif CFG.device == 'TPU':\n if step % CFG.print_freq == 0 or step == (len(train_loader)-1):\n xm.master_print('Epoch: [{0}][{1}/{2}] '\n 'Data {data_time.val:.3f} ({data_time.avg:.3f}) '\n 'Elapsed {remain:s} '\n 'Loss: {loss.val:.4f}({loss.avg:.4f}) '\n 'Grad: {grad_norm:.4f} '\n #'LR: {lr:.6f} '\n .format(\n epoch+1, step, len(train_loader), batch_time=batch_time,\n data_time=data_time, loss=losses,\n remain=timeSince(start, float(step+1)/len(train_loader)),\n grad_norm=grad_norm,\n #lr=scheduler.get_lr()[0],\n ))\n return losses.avg\n\n\ndef valid_fn(valid_loader, model, criterion, device):\n batch_time = AverageMeter()\n data_time = AverageMeter()\n losses = AverageMeter()\n scores = AverageMeter()\n # switch to evaluation mode\n model.eval()\n trues = []\n preds = []\n start = end = time.time()\n for step, (images, labels) in enumerate(valid_loader):\n # measure data loading time\n data_time.update(time.time() - end)\n images = images.to(device)\n labels = labels.to(device)\n batch_size = labels.size(0)\n # compute loss\n with torch.no_grad():\n y_preds = model(images)\n loss = criterion(y_preds, labels)\n losses.update(loss.item(), batch_size)\n # record accuracy\n trues.append(labels.to('cpu').numpy())\n preds.append(y_preds.softmax(1).to('cpu').numpy())\n if CFG.gradient_accumulation_steps > 1:\n loss = loss / CFG.gradient_accumulation_steps\n # measure elapsed time\n batch_time.update(time.time() - end)\n end = time.time()\n if CFG.device == 'GPU':\n if step % CFG.print_freq == 0 or step == (len(valid_loader)-1):\n print('EVAL: [{0}/{1}] '\n 'Data {data_time.val:.3f} ({data_time.avg:.3f}) '\n 'Elapsed {remain:s} '\n 'Loss: {loss.val:.4f}({loss.avg:.4f}) '\n .format(\n step, len(valid_loader), batch_time=batch_time,\n data_time=data_time, loss=losses,\n remain=timeSince(start, float(step+1)/len(valid_loader)),\n ))\n elif CFG.device == 'TPU':\n if step % CFG.print_freq == 0 or step == (len(valid_loader)-1):\n xm.master_print('EVAL: [{0}/{1}] '\n 'Data {data_time.val:.3f} ({data_time.avg:.3f}) '\n 'Elapsed {remain:s} '\n 'Loss: {loss.val:.4f}({loss.avg:.4f}) '\n .format(\n step, len(valid_loader), batch_time=batch_time,\n data_time=data_time, loss=losses,\n remain=timeSince(start, float(step+1)/len(valid_loader)),\n ))\n trues = np.concatenate(trues)\n predictions = np.concatenate(preds)\n return losses.avg, predictions, trues","execution_count":null,"outputs":[]},{"metadata":{},"cell_type":"markdown","source":"# Train loop"},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# Train loop\n# ====================================================\ndef train_loop(folds, fold):\n\n LOGGER.info(f\"========== fold: {fold} training ==========\")\n\n # ====================================================\n # loader\n # ====================================================\n trn_idx = folds[folds['fold'] != fold].index\n val_idx = folds[folds['fold'] == fold].index\n\n train_folds = folds.loc[trn_idx].reset_index(drop=True)\n valid_folds = folds.loc[val_idx].reset_index(drop=True)\n\n train_dataset = TrainDataset(train_folds, transform=get_transforms(data='train'))\n valid_dataset = TrainDataset(valid_folds, transform=get_transforms(data='valid'))\n \n train_loader = DataLoader(train_dataset, \n batch_size=CFG.batch_size, \n shuffle=True, \n num_workers=CFG.num_workers, pin_memory=True, drop_last=True)\n valid_loader = DataLoader(valid_dataset, \n batch_size=CFG.batch_size, \n shuffle=False, \n num_workers=CFG.num_workers, pin_memory=True, drop_last=False)\n \n valid_labels = valid_folds[CFG.target_col].values\n \n # ====================================================\n # scheduler \n # ====================================================\n def get_scheduler(optimizer):\n if CFG.scheduler=='ReduceLROnPlateau':\n scheduler = ReduceLROnPlateau(optimizer, mode='min', factor=CFG.factor, patience=CFG.patience, verbose=True, eps=CFG.eps)\n elif CFG.scheduler=='CosineAnnealingLR':\n scheduler = CosineAnnealingLR(optimizer, T_max=CFG.T_max, eta_min=CFG.min_lr, last_epoch=-1)\n elif CFG.scheduler=='CosineAnnealingWarmRestarts':\n scheduler = CosineAnnealingWarmRestarts(optimizer, T_0=CFG.T_0, T_mult=1, eta_min=CFG.min_lr, last_epoch=-1)\n elif CFG.scheduler=='GradualWarmupSchedulerV2':\n scheduler_cosine=torch.optim.lr_scheduler.CosineAnnealingWarmRestarts(optimizer, CFG.cosine_epo)\n scheduler_warmup=GradualWarmupSchedulerV2(optimizer, multiplier=10, total_epoch=CFG.warmup_epo, after_scheduler=scheduler_cosine)\n scheduler=scheduler_warmup\n return scheduler\n\n # ====================================================\n # model & optimizer\n # ====================================================\n if CFG.device == 'TPU':\n device = xm.xla_device()\n xm.set_rng_state(CFG.seed, device)\n elif CFG.device == 'GPU':\n device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')\n \n \n def get_model(pretrained=False):\n if CFG.model_name=='deit_base_patch16_224':\n model = CustomDeiT(model_name=CFG.model_name, pretrained=pretrained)\n elif CFG.model_name=='vit_base_patch16_384':\n model = CustomViT(model_name=CFG.model_name, pretrained=pretrained)\n elif CFG.model_name=='resnext50_32x4d':\n model = CustomResNext(CFG.model_name, pretrained=pretrained)\n elif CFG.model_name=='tf_efficientnet_b3_ns':\n model = CustomEfficientNet(CFG.model_name, pretrained=pretrained)\n return model\n \n\n model = get_model(pretrained=False) \n \n # ====================================================\n # Freeze other layers\n # ====================================================\n\n if CFG.freeze:\n model.load_state_dict(load_state(model_path[fold], model))\n model.freeze()\n \n model.to(device)\n\n #optimizer = Adam(model.parameters(), lr=CFG.lr, weight_decay=CFG.weight_decay, amsgrad=False)\n optimizer = Adam(filter(lambda p: p.requires_grad, model.parameters()), lr=CFG.lr, weight_decay=CFG.weight_decay, amsgrad=False)\n scheduler = get_scheduler(optimizer)\n \n \n # ====================================================\n # Criterion - ['LabelSmoothing', 'FocalLoss' 'FocalCosineLoss', 'SymmetricCrossEntropyLoss', 'BiTemperedLoss', 'TaylorCrossEntropyLoss']\n # ====================================================\n \n def get_criterion():\n if CFG.criterion=='CrossEntropyLoss':\n criterion = nn.CrossEntropyLoss()\n elif CFG.criterion=='LabelSmoothing':\n criterion = LabelSmoothingLoss(classes=CFG.target_size, smoothing=CFG.smoothing)\n elif CFG.criterion=='FocalLoss':\n criterion = FocalLoss().to(device)\n elif CFG.criterion=='FocalCosineLoss':\n criterion = FocalCosineLoss()\n elif CFG.criterion=='SymmetricCrossEntropyLoss':\n criterion = SymmetricCrossEntropy().to(device)\n elif CFG.criterion=='BiTemperedLoss':\n criterion = BiTemperedLogisticLoss(t1=CFG.t1, t2=CFG.t2, smoothing=CFG.smoothing)\n elif CFG.criterion=='TaylorCrossEntropyLoss':\n criterion = TaylorCrossEntropyLoss(smoothing=CFG.smoothing)\n return criterion\n\n\n # ====================================================\n # loop \n # ====================================================\n criterion = get_criterion()\n LOGGER.info(f'Criterion: {criterion}')\n\n best_score = 0.\n best_loss = np.inf\n \n for epoch in range(CFG.epochs):\n \n start_time = time.time()\n \n # train\n if CFG.device == 'TPU':\n if CFG.nprocs == 1:\n avg_loss = train_fn(train_loader, model, criterion, optimizer, epoch, scheduler, device)\n elif CFG.nprocs == 8:\n para_train_loader = pl.ParallelLoader(train_loader, [device])\n avg_loss = train_fn(para_train_loader.per_device_loader(device), model, criterion, optimizer, epoch, scheduler, device)\n elif CFG.device == 'GPU':\n avg_loss = train_fn(train_loader, model, criterion, optimizer, epoch, scheduler, device)\n \n # eval\n if CFG.device == 'TPU':\n if CFG.nprocs == 1:\n avg_val_loss, preds, _ = valid_fn(valid_loader, model, criterion, device)\n elif CFG.nprocs == 8:\n para_valid_loader = pl.ParallelLoader(valid_loader, [device])\n avg_val_loss, preds, valid_labels = valid_fn(para_valid_loader.per_device_loader(device), model, criterion, device)\n preds = idist.all_gather(torch.tensor(preds)).to('cpu').numpy()\n valid_labels = idist.all_gather(torch.tensor(valid_labels)).to('cpu').numpy()\n elif CFG.device == 'GPU':\n avg_val_loss, preds, _ = valid_fn(valid_loader, model, criterion, device)\n \n if isinstance(scheduler, ReduceLROnPlateau):\n scheduler.step(avg_val_loss)\n elif isinstance(scheduler, CosineAnnealingLR):\n scheduler.step()\n elif isinstance(scheduler, CosineAnnealingWarmRestarts):\n scheduler.step()\n elif isinstance(scheduler, GradualWarmupSchedulerV2):\n scheduler.step(epoch)\n\n # scoring\n score = get_score(valid_labels, preds.argmax(1))\n\n elapsed = time.time() - start_time\n\n if CFG.device == 'GPU':\n LOGGER.info(f'Epoch {epoch+1} - avg_train_loss: {avg_loss:.4f} avg_val_loss: {avg_val_loss:.4f} time: {elapsed:.0f}s')\n LOGGER.info(f'Epoch {epoch+1} - Score: {score:.4f}')\n elif CFG.device == 'TPU':\n if CFG.nprocs == 1:\n LOGGER.info(f'Epoch {epoch+1} - avg_train_loss: {avg_loss:.4f} avg_val_loss: {avg_val_loss:.4f} time: {elapsed:.0f}s')\n LOGGER.info(f'Epoch {epoch+1} - Score: {score:.4f}')\n elif CFG.nprocs == 8:\n xm.master_print(f'Epoch {epoch+1} - avg_train_loss: {avg_loss:.4f} avg_val_loss: {avg_val_loss:.4f} time: {elapsed:.0f}s')\n xm.master_print(f'Epoch {epoch+1} - Score: {score:.4f}')\n \n if score > best_score:\n best_score = score\n if CFG.device == 'GPU':\n LOGGER.info(f'Epoch {epoch+1} - Save Best Score: {best_score:.4f} Model')\n torch.save({'model': model.state_dict(), \n 'preds': preds},\n OUTPUT_DIR+f'{CFG.model_name}_fold{fold}_best_score.pth')\n elif CFG.device == 'TPU':\n if CFG.nprocs == 1:\n LOGGER.info(f'Epoch {epoch+1} - Save Best Score: {best_score:.4f} Model')\n elif CFG.nprocs == 8:\n xm.master_print(f'Epoch {epoch+1} - Save Best Score: {best_score:.4f} Model')\n xm.save({'model': model, \n 'preds': preds}, \n OUTPUT_DIR+f'{CFG.model_name}_fold{fold}_best_score.pth')\n \n if CFG.nprocs != 8:\n check_point = torch.load(OUTPUT_DIR+f'{CFG.model_name}_fold{fold}_best_score.pth')\n valid_folds['preds'] = check_point['preds'].argmax(1)\n\n return valid_folds","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"# ====================================================\n# main\n# ====================================================\ndef main():\n def get_result(result_df):\n preds = result_df['preds'].values\n labels = result_df[CFG.target_col].values\n score = get_score(labels, preds)\n LOGGER.info(f'Score: {score:<.5f}')\n \n if CFG.train:\n # train \n oof_df = pd.DataFrame()\n for fold in range(CFG.n_fold):\n if fold in CFG.trn_fold:\n _oof_df = train_loop(folds, fold)\n oof_df = pd.concat([oof_df, _oof_df])\n if CFG.nprocs != 8:\n LOGGER.info(f\"========== fold: {fold} result ==========\")\n get_result(_oof_df)\n \n if CFG.nprocs != 8:\n # CV result\n LOGGER.info(f\"========== CV ==========\")\n get_result(oof_df)\n # save result\n oof_df.to_csv(OUTPUT_DIR+'oof_df.csv', index=False)","execution_count":null,"outputs":[]},{"metadata":{"trusted":true},"cell_type":"code","source":"if __name__ == '__main__':\n if CFG.device == 'TPU':\n def _mp_fn(rank, flags):\n torch.set_default_tensor_type('torch.FloatTensor')\n #xm.set_rng_state()\n a = main()\n FLAGS = {}\n xmp.spawn(_mp_fn, args=(FLAGS,), nprocs=CFG.nprocs, start_method='fork')\n elif CFG.device == 'GPU':\n main()","execution_count":null,"outputs":[]}],"metadata":{"kernelspec":{"language":"python","display_name":"Python 3","name":"python3"},"language_info":{"pygments_lexer":"ipython3","nbconvert_exporter":"python","version":"3.6.4","file_extension":".py","codemirror_mode":{"name":"ipython","version":3},"name":"python","mimetype":"text/x-python"}},"nbformat":4,"nbformat_minor":4}